AI零帧起手写算子,反超DeepSeek人类手写巅峰:快了9.8%! النص الأصلي بالصينية
金磊 发自 凹非寺
量子位 | 公众号 QbitAI
没有源码,没有论文,直接从零开始。
就在今早,ForgeKernel, 一个无人参与的Agent在无需参考DeepSeek原始实现的情况下,就当着全网的面,把DeepSeek最新的核心算子写快了9.8%!
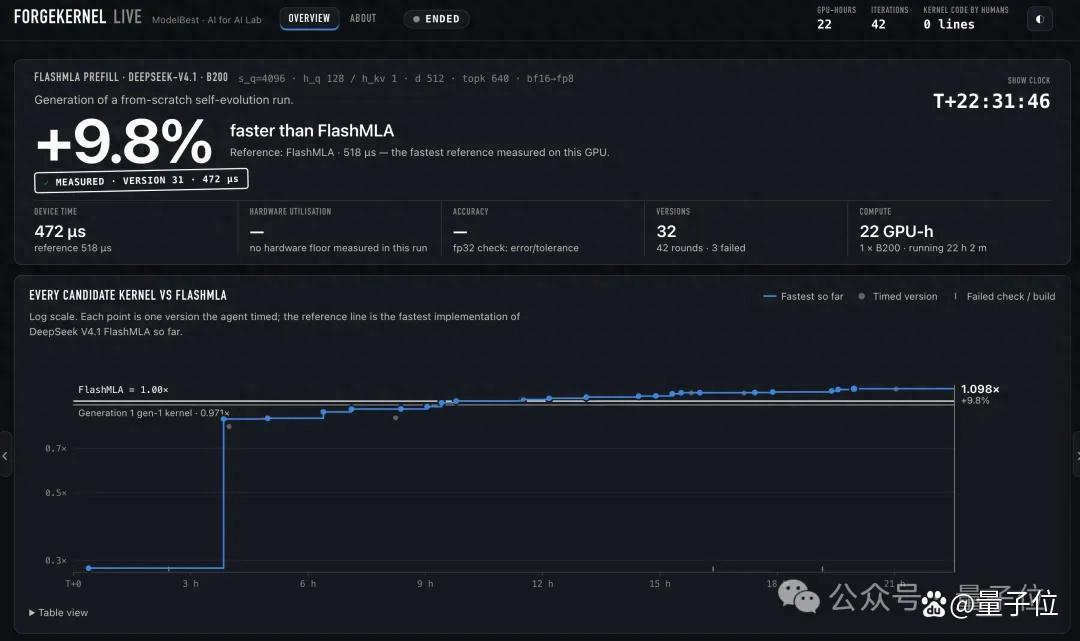
并且整个过程的直播,仅仅花了22.5小时的时间(从设计算子的角度来看,消耗时间算短的),也引来了不少网友的围观:
具体来说,这个直播的内容是一个Agent在英伟达B200上,超越DeepSeek-V4.1的FlashMLA Prefill算子。
FlashMLA是DeepSeek开源的注意力核心算子库,10月20日刚开源的推理框架DeepInfer也把它集成在内;它出自业内公认Infra最强的团队之手,可以说是代表了人类手写算子的巅峰。而也正如我们刚才所说,AI拿到的只有算子的数学定义和目标硬件约束,它要0帧起手,通过自进化一轮轮改进。
在这22.5个小时里,每一次改写、每一个性能数字的跳动,就这么水灵灵地摆在了全网观众眼前:
第一版通过了正确性检查,但耗时1834微秒,效率相对较低;
不到4小时,耗时压到593微秒,降幅约67.6%,已从零逼近当前最佳实现的九成;
第7小时前后,一次核心结构突破让它先超过了自己的上一代版本,随后首次超过FlashMLA;
上午9点多,直播结束。最终版本耗时472微秒,FlashMLA为518微秒,快了9.8%。
全程42轮迭代,留下32个版本,用了1张B200和22个GPU小时;而人类为这个算子写的代码是,0行。
手写巅峰,就这样被一份人类没写一行代码的算子越过了。
那么这到底是何许Agent?
它,正是来自面壁智能的算子生成系统ForgeKernel;并且在本场直播结束之后,智能进化实验室随即联合OpenBMB社区宣布开源。
不过这场直播还并非是ForgeKernel的首次亮相,早在前几天,它就已经famous过一次了。
包揽了国产算力三个第一
就在10月27日,昇腾CANN官方发文,就“点名”了一下ForgeKernel——
同时登顶CANNBench 950DT、950PR、A3三大硬件榜单!
这三个榜单分别对应的三类昇腾硬件,它们的成绩看点可以说是各有不同。
我们先来看下950DT这个榜单,这也是三张榜里经济账算得最明显的一张。
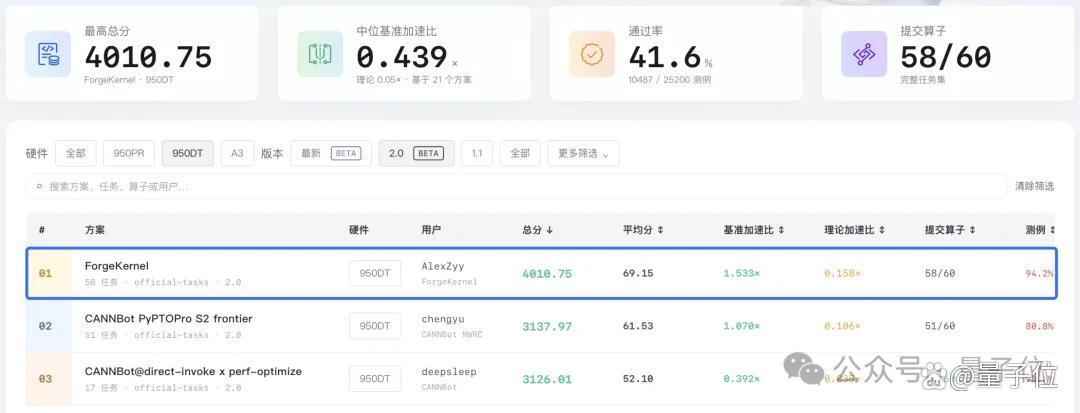
ForgeKernel在这张榜上以4010.75分排名第一,领先第二名27.8%;基准加速比1.533×,约为第二名的143%。
这就意味着在同等硬件投入下,可用算力增长接近50%,企业的算力采购与部署成本可相应降低约一半。
之所以这个榜单值得关注,是因为950DT是新一代芯片,配套算子库尚在建设初期,人工适配周期长,而ForgeKernel率先完成了适配并登顶。
这说明新硬件刚上市,AI就能快速产出高质量算子,芯片从上市到适配好之间的空窗期,正在被大幅压缩。
950PR则是三张榜里竞争最激烈的一张,前三名的基准加速比都达到了1.3倍:
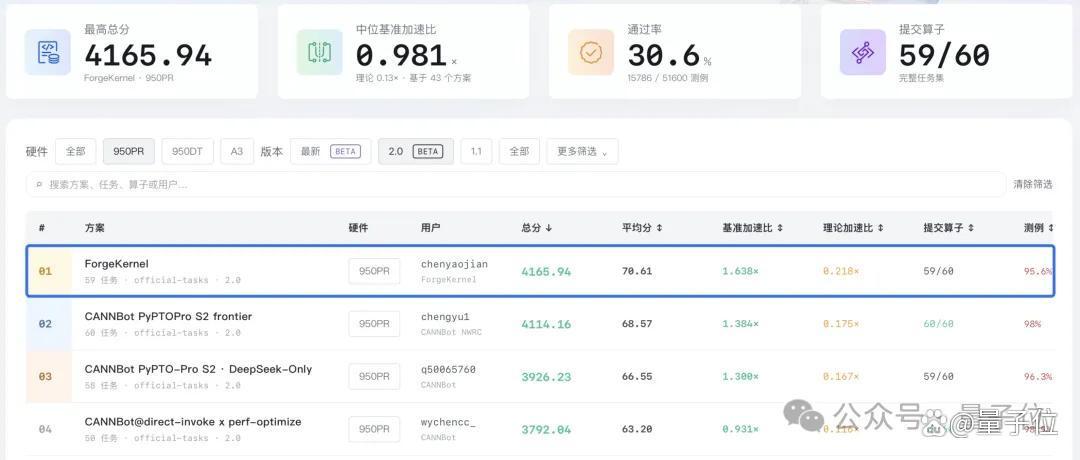
ForgeKernel在这张榜上总分4165.94,同样排名第一;基准加速比1.638×,约为第二名的1.18倍。
最后,就是A3,也就是目前广泛使用的昇腾910C。
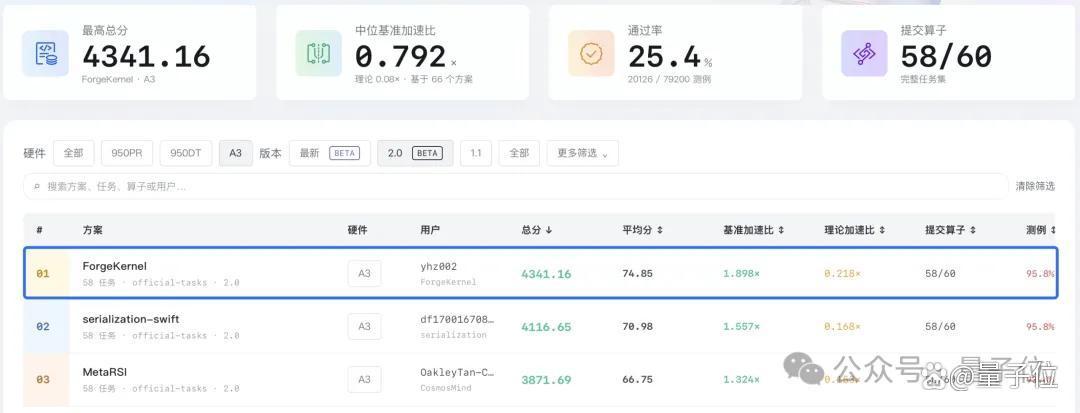
早在10月15日封榜的CANNBench v1.1中,它就已拿下A3硬件榜第一;v2.0开榜后,这个位置一直没有让出,目前总分4341.16,基准加速比1.898×,约为第二名的1.22倍。
在这次直播中,ForgeKernel是跑在英伟达B200上,用的是CUDA,这套生态攒了多年的专家经验;而这三张榜单是在昇腾上跑的,昇腾有自己独立的架构和工具链。
虽然两边的软硬件差别很大,但ForgeKernel却能用同一套系统,在两边都拿到了第一。
那么接下来的问题是,它是如何做到的呢?
是无师自通的那种
模型最终能跑多快,很大程度上得看算子。
因为同一款模型、同一块芯片,换一套更高效的算子,性能就会拉开明显差距。
而长期以来,高性能算子依赖资深工程师逐个手写调优,周期长、门槛高。CUDA生态走到今天,靠的是多年的专家积累;而国产芯片每出一代新硬件、每来一个新模型,都要重新适配一遍。
一言以蔽之,人类专家的数量,跟不上芯片和模型的迭代速度。
那么此局又该如何破解?
10月27日,ForgeKernel团队与清华大学等机构在arXiv发布了一篇名为JustGoal:With Only a Goal,the AI Baseline Is Above the Expert Kernels的论文。
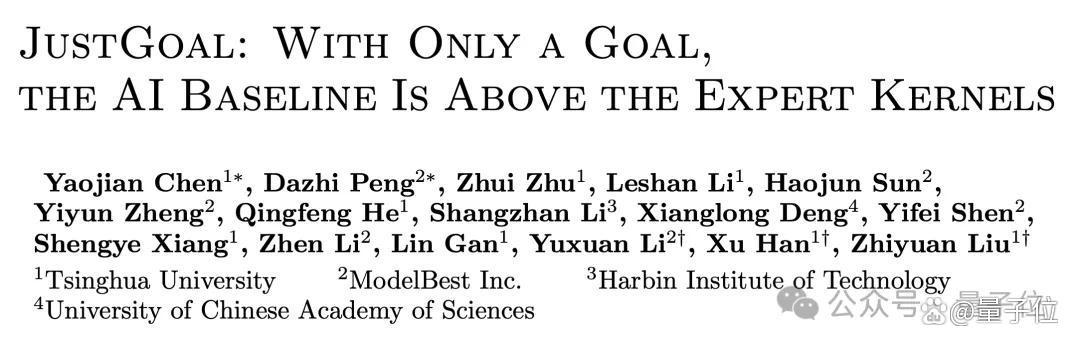
在这篇论文中,研究团队只给模型一个优化目标,不提供任何算子知识,也不规定固定流程,让它自己去写。结果在B200上,模型在10个算子中的8个跑赢了人类维护的开源库。
他们还让同一个模型套上MIT韩松团队参与开发的专用框架KDA-0.5,在单配置优化任务上的平均成绩反而只有JustGoal的0.95×。也就是说,写算子越来越依赖模型自身的能力,专家预先写好的经验和流程,作用在变小。
不过,只给目标也有做不到的地方。模型擅长调细节,却难以独立设计好整体架构,常常在开局几次尝试中就把路线定死,之后只能在原有架构里微调。ForgeKernel就是在JustGoal的基础上,专门补这块短板的。
它的做法可以分成三部分:
一是把架构设计和实现能力分离,并把架构设计抽象成里程碑,拆解问题;
二是把每一条实测验证过的硬件经验存进知识库,换一个算子也能接着用;
三是把自己写出的最好版本当作下一轮的对手,一轮轮自进化。
而这三部分,刚好可以与我们刚才展示的直播一一对应。
ForgeKernel先超过了自己的上一代版本,接着才超过FlashMLA,这就是自进化。
到了后期,它还自己发现Q的突发加载在和KV数据搬运争抢访存资源,于是主动控制Q的请求节奏,又压下2.4%的耗时,这种判断过去要靠资深专家来做。
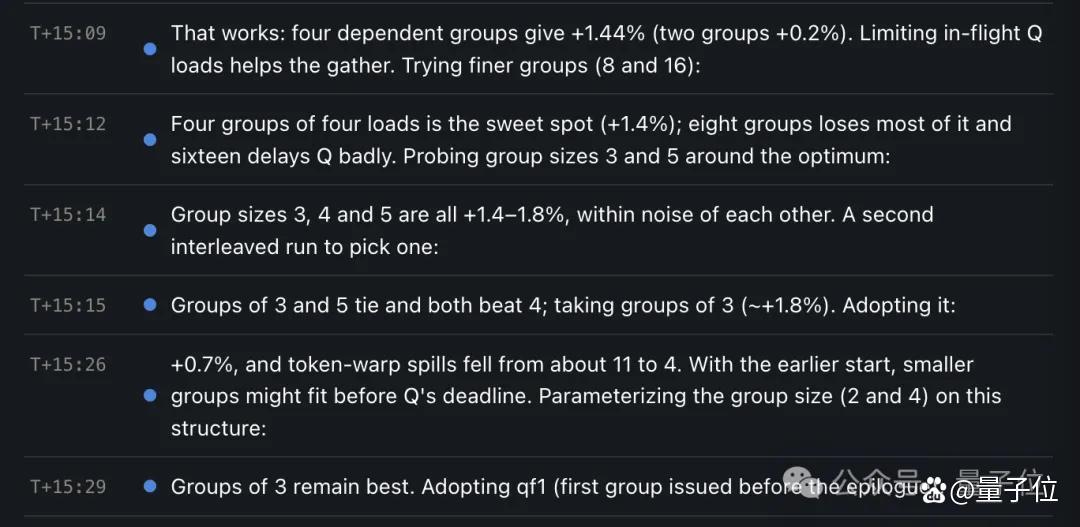
△ForgeKernel Live 中的 Agent 运行日志
放到更多算子上,ForgeKernel在29项对比中有24项打平或超越专家实现,三套领先Agent系统公开的7个最强算子,也全部打平或超越。
这份收益,还能在不同的国产芯片之间复制,因为ForgeKernel的设计对国产芯片还有一个好处,那就是不依赖于具体的某一款硬件。
具体的算子实现,要贴着每款芯片的硬件特性来写,没法照搬;但ForgeKernel组织优化的方法是通用的,没有为任何一款芯片预设固定流程。从英伟达换到昇腾,它只需把性能分析工具从NCU换成msprof,新芯片需要的硬件知识,再由模型在这块芯片上边测边积累。
这样一来,ForgeKernel可以快速迁移到其他国产芯片上,新一代国产芯片推出时,也不必再从零搭建一套适配流程。
省下的是真金白银
如果算子能快上1%,这又到底意味着什么呢?
据Gartner最新预测,2026年全球AI基础设施支出约1.48万亿美元。按这个量级,算力效率每提升1%,对应的就是约148亿美元。
若是放到国产芯片上,这笔账会更加明显一些。
英伟达的CUDA已经被专家优化了多年,现成的高性能算子很多,AI再往上提速的余地有限;国产芯片配套的算子库还不完善,不少算子没有经过充分调优,AI能带来的提升也就更明显一些。
ForgeKernel团队用AI优化训练框架时,也看到了这个差别,同样的做法在国产芯片上能提速20%~30%,在英伟达上为5%~10%,这意味着,ForgeKernel可以进一步提高国产芯片在训练和推理任务上的性价比,缩小与英伟达的差距。
当写代码对AI几乎不花成本以后,很多以前嫌专家太贵、算不过账的优化就值得做了,比如给某个模型或某颗芯片单独定制一套算子。
事实上,这些超越人类专家的算子并没有停留在榜单上,而是已经走向了真实的产业一线。
目前,ForgeKernel生成的算子已正式接入训练框架,在国产芯片与英伟达平台上完成了MiniCPM5-1B的长训测试。
更值得注意的是,在这场算力底层的重构中,以DeepSeek V4.1为代表的国产大模型,已经开始参与到算子的生成和优化中;而这些算子,最终又稳稳地跑在国产芯片之上。
“国产模型写算子,国产芯片跑算子”,一条属于中国AI的全栈生态闭环正在成型。
这不仅是算子的胜利,更是RSI(递归自进化)落地的真实缩影:AI研发的行为主体,正在从人类转向AI。
正如面壁智能智能进化首席科学家李宇轩所说,由于代码能被机器快速验证,工程落地会比理论研究率先实现闭环:
过去,像 FlashAttention 系列这样需要深度重构架构的顶尖算子,人类专家往往需要数月甚至半年才能完成一次迭代;而如今在团队内部,AI 超越最佳人类实现的算子优化任务,最多只需两天就能完成。
而随着ForgeKernel的正式开源,这套方法也将作为基础设施,为国产芯片厂商和模型团队提供了新的效率路径。
以前国产芯片要追赶英伟达,难的往往不是硬件指标,反倒是CUDA生态里堆积了十几年的专家经验与软件分层。但在RSI的范式下,AI正在把这种依靠人力堆叠、耗时数年建立的生态壁垒彻底打穿,直接端到端生成最优解。
当“国产模型写算子,国产芯片跑算子”成为新的算子工程范式,研发的主体或许正在不可逆地从人类转向模型。但这并不意味着人类专家的离场,只是他们的工作重心发生了根本性的跃迁:
从亲手打磨每一行底层代码,转向为AI搭建环境、设定目标与验证标准,去配合AI把算子写得更好。
当人类从代码工匠转变为系统架构师,国产芯片在“能跑”和“跑好”之间的鸿沟,正在被AI以小时为单位迅速填平。
举报/反馈
مهتم بالتعاون بشأن هذا المقال؟
سنعاود الاتصال بك خلال يوم عمل واحد