GitHub不堪重负!OpenAI收购替代品,A社原地自研,马斯克也要搞 Chinese original
听雨 发自 凹非寺量子位 | 公众号QbitAI
GitHub,你怎么又出故障了……
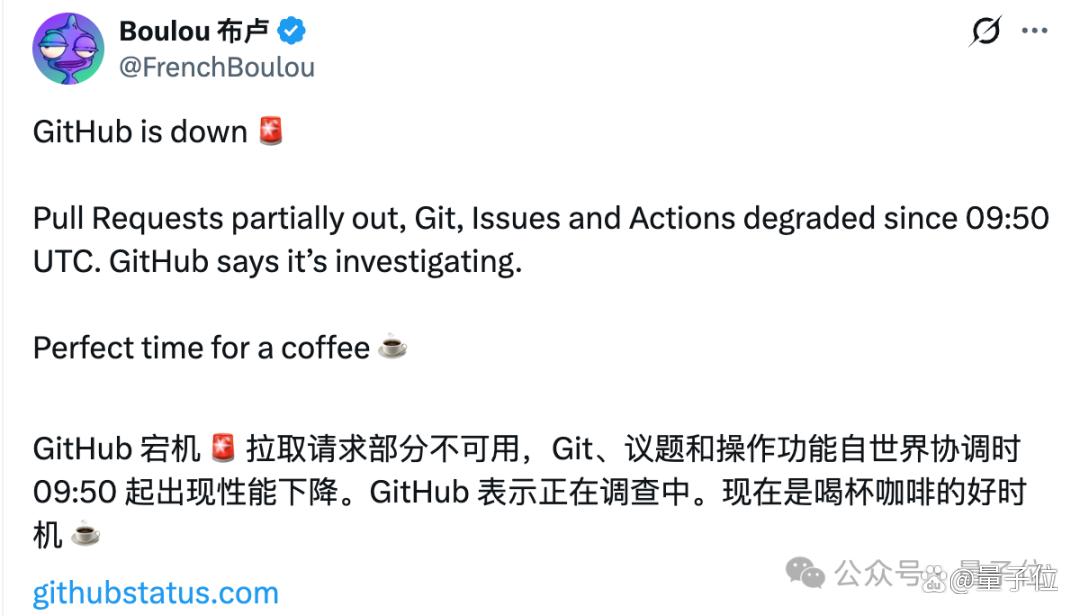
11月3日,官方状态页一天就记下了两起故障,其中一起影响Git操作。
到了4日,合并请求等服务又出现异常,部分请求失败或延迟。
代码改好了,想让同事看看能不能并进主项目,偏偏卡在了这一步。
还有网友因此打趣:
正好去喝杯咖啡。
 图片
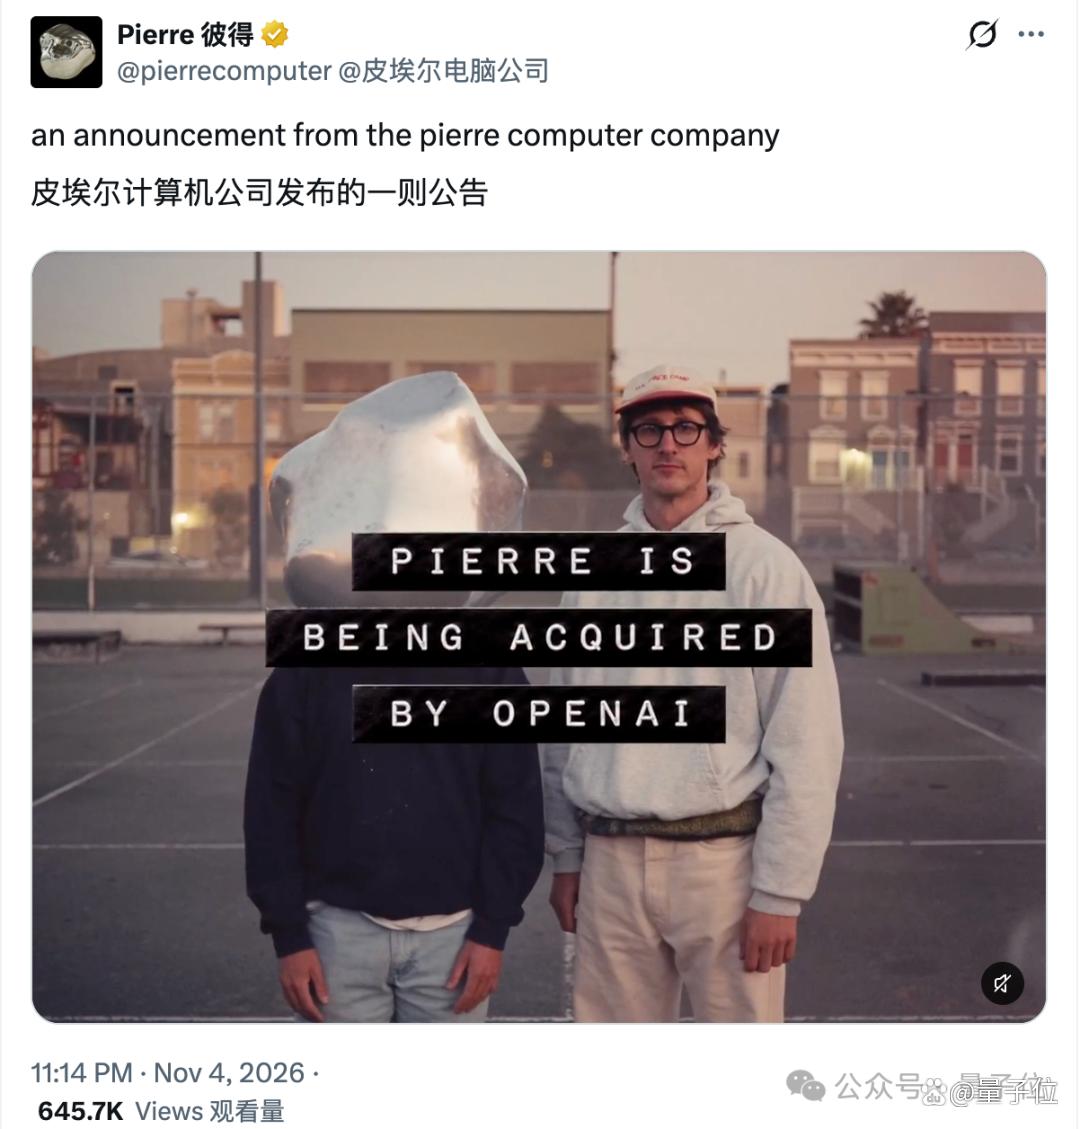
就在GitHub忙着抢修的时候,Axios发出一条独家消息:
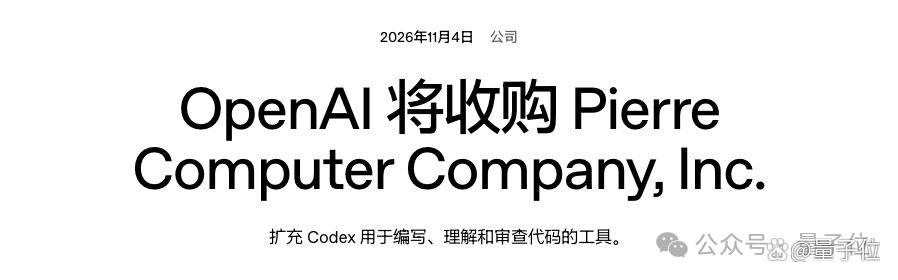
OpenAI拟收购做代码托管工具的Pierre,交易仍待交割。
 图片
这两条消息撞在一起,时间有点赶巧啊。
而且不得不说,做AI编程工具的公司,还真有好几家开始自己管代码了。
马斯克旗下的Cursor,已经允许开发者把整个项目直接存在Cursor里。
Anthropic更进一步,把自家工程师天天用的主代码库搬进了自研系统。
几家公司为什么都开始折腾这件事?
因为AI写代码的速度越来越快,基础设施已经逐渐跟不上了……
 图片
OpenAI自己造了一个,还准备再买一家
OpenAI自己就尝过代码系统跟不上的滋味。
今年3月,The Information就报道过,OpenAI工程师多次遇到GitHub服务中断,公司正在开发内部替代工具。
到了11月2日——就在前几天,它公开了自己的Git后端Pando,负责承接内部代码的存取等操作。
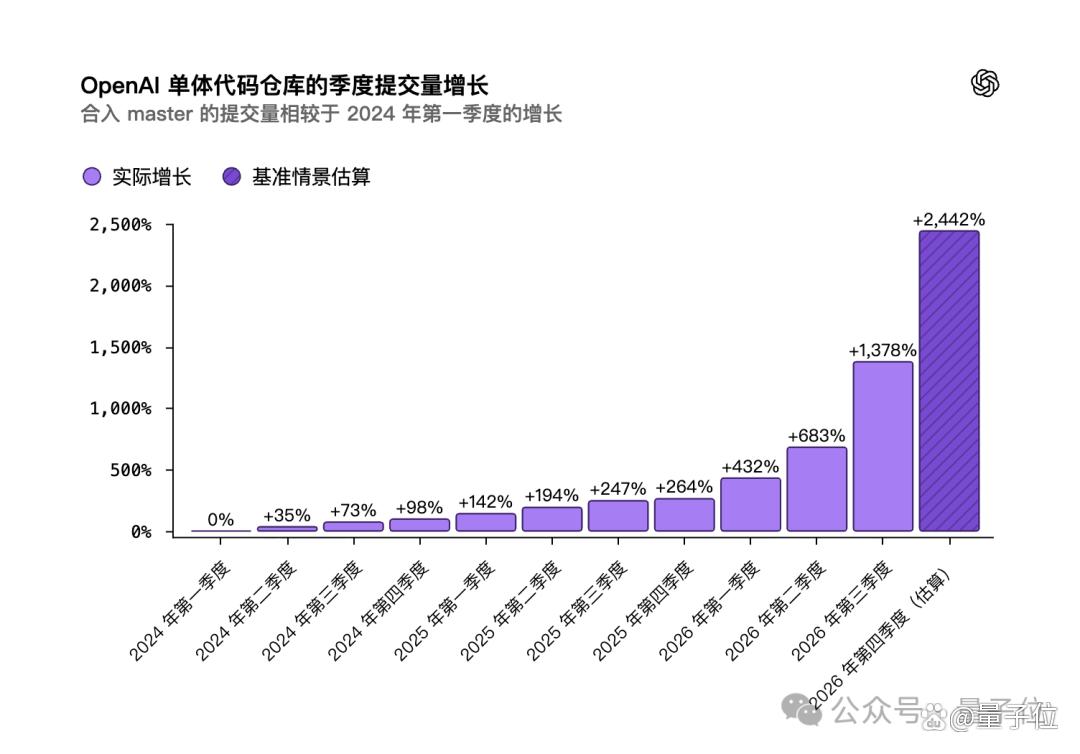
据工程团队介绍,以前,一个工程师手里推进一份改动。有了Codex,一个人可以同时准备好几份。
 图片
而每推送一次代码,又会触发多个自动化任务,去取代码、运行检查。
写代码的人没有突然多出好几倍,系统要处理的工作却增加了。
原来的系统渐渐吃力,拉取、推送变慢,合并也会失败。
Pando从4月起就开始承接真实的开发流量。按OpenAI的统计,换上之后,一次推送的中位耗时降了近八成。
自家工程师的问题解决了,面向Codex用户,OpenAI还准备通过收购Pierre,把代码存储等能力带进产品里。
 图片
说起来,Pierre的东西,你可能已经用过了~
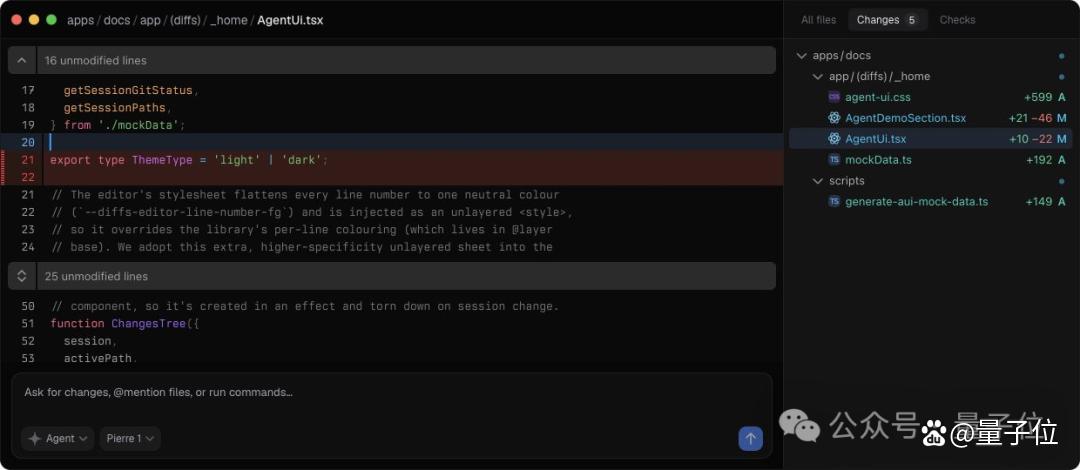
假设你让Codex修一个bug,它一口气改了五个文件。
你点开文件列表,找到其中一个,再逐行对照它删了什么、加了什么。
前一个动作,用的是Pierre做的Trees;后一个,用的是Pierre做的Diffs。这两套工具早就接进了Codex。
 图片
Pierre还有一门生意叫Code Storage,它的客户里,就有AI应用开发平台Lovable。
用户在Lovable里输入几句话,就能做出一个网站。在后台,每个项目都要用一个或多个Git仓库来保存代码和修改历史。
据Pierre今年8月披露的数据,当时Lovable每周新建超过800万个仓库,峰值达到每秒250个。
OpenAI打算等收购完成,再把Code Storage的能力带进Codex。
以后,开发者让AI写代码、查看它改了哪里,再把这一版存下来,都有望在Codex里完成。
目前,这笔交易还要满足监管批准等交割条件。
Cursor开放代码托管那天,GitHub也挂了
大家可能还记得,8月14日,马斯克的SpaceX完成对Cursor的收购。
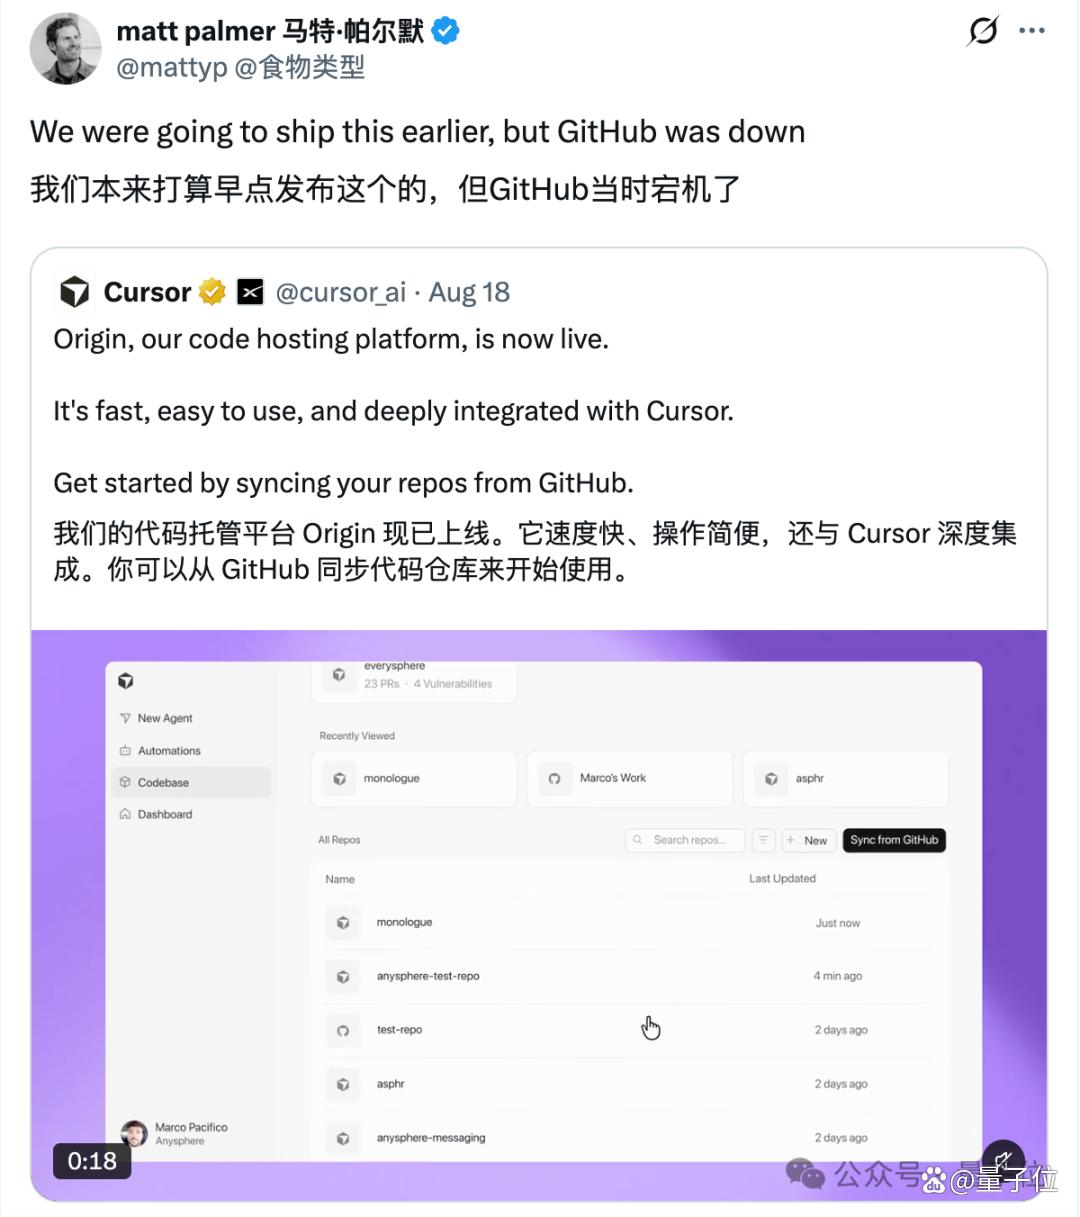
三天后,Cursor的代码托管服务Origin开放早期测试。
结果偏偏就在8月17日,GitHub也发生了一场持续7小时47分钟的故障。
Cursor员工Matt Palmer当时还开了个玩笑,大意是,他们本来想更早发的,可GitHub,它、它又挂了!!
 图片
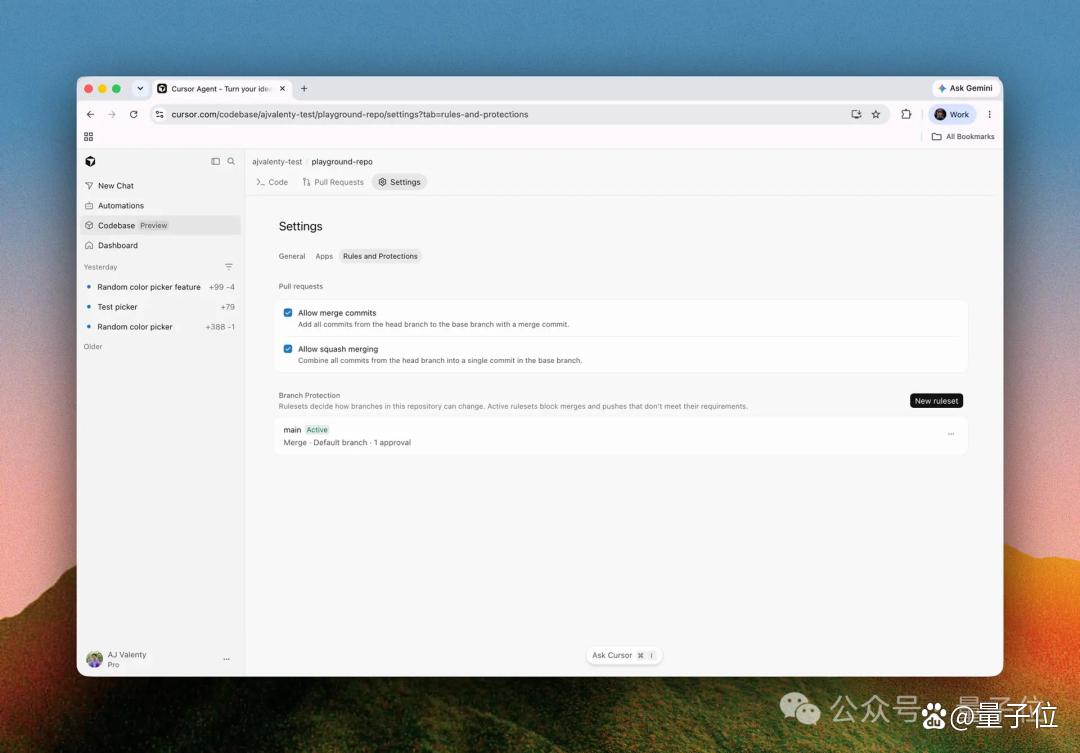
Origin给了开发者两种选择:做新项目,可以直接在Origin建仓库,代码推到Cursor,请同事审、接收修改意见、合并分支,这些操作都能绕开GitHub。
老项目如果已经放在GitHub,也可以只同步一份到Cursor。
你在Cursor里留下的评论,队友回到GitHub也能看到,代码仍以GitHub上的版本为准。
 图片
那问题就来了:
写代码、审代码、合并,都能在Cursor里办完了,那我还专门打开GitHub干啥?
哪怕是老项目,仓库还放在GitHub,但审代码的人也已经可以不去那儿了。
Claude写得太快,Anthropic自己造了一套
OpenAI和Cursor把更多开发操作接进了自己的产品,而到了Anthropic内部,工作量已经大到需要重做代码管理系统。
主要还是因为,Claude写代码写得太快了……
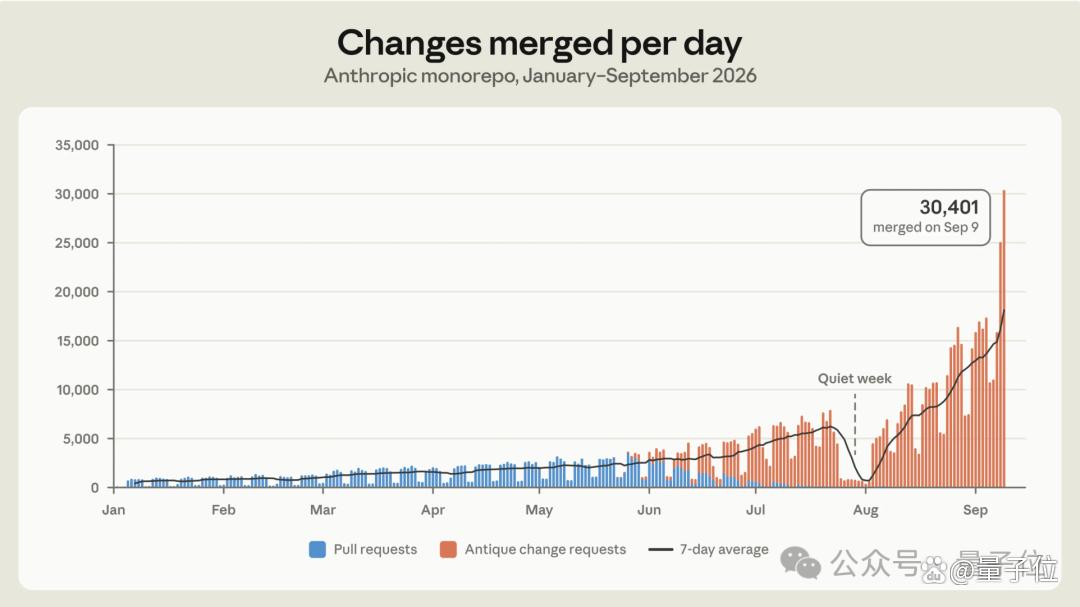
据Anthropic披露,今年5月,公司平均每天合并约2500项代码改动。到了9月,一天已经超过3万项。
也就是每天有超过3万份修改,被合并进团队共同维护的代码版本。
 图片
光是用于自动化测试等工作的持续集成任务,每天就要取用约2500万次代码。
高峰期,公司维护着数百个Git镜像,用这些仓库副本分担负载。可主仓库更新得越快,这些副本就越难维护。
工程师发现,来取代码的大多是始终在线的Agent和自动化任务。
有的任务,只是想知道一个文件改了哪几行,何必先在本地备好一份仓库?让服务器算好,把结果发过去就行。
照着这个思路,Anthropic造出了Scion。
客户端用到哪个文件,再去取哪个。查历史、建提交、合并改动,则交给服务器。
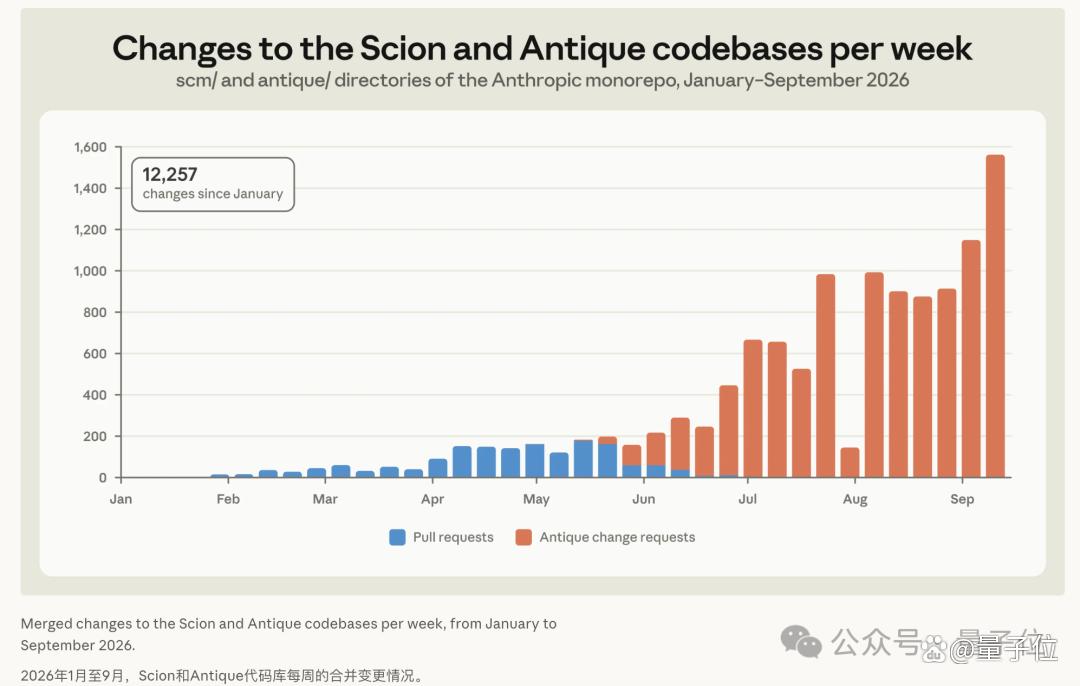
7名工程师借助Claude,花5个月做出了这套内部版本控制系统,以及配套的代码审查工具Antique等,还把公司的主代码库整个迁了过去。
 图片
不过,Scion主要服务于Anthropic这种规模庞大、改动频繁的内部代码库。
Claude Code的公开仓库等社区资源,仍然保留在GitHub上。
一天三万项改动,谁来检查?
代码取得更快、存得更顺之后,还有一个更棘手的问题:
这些修改,怎么判断能不能用?
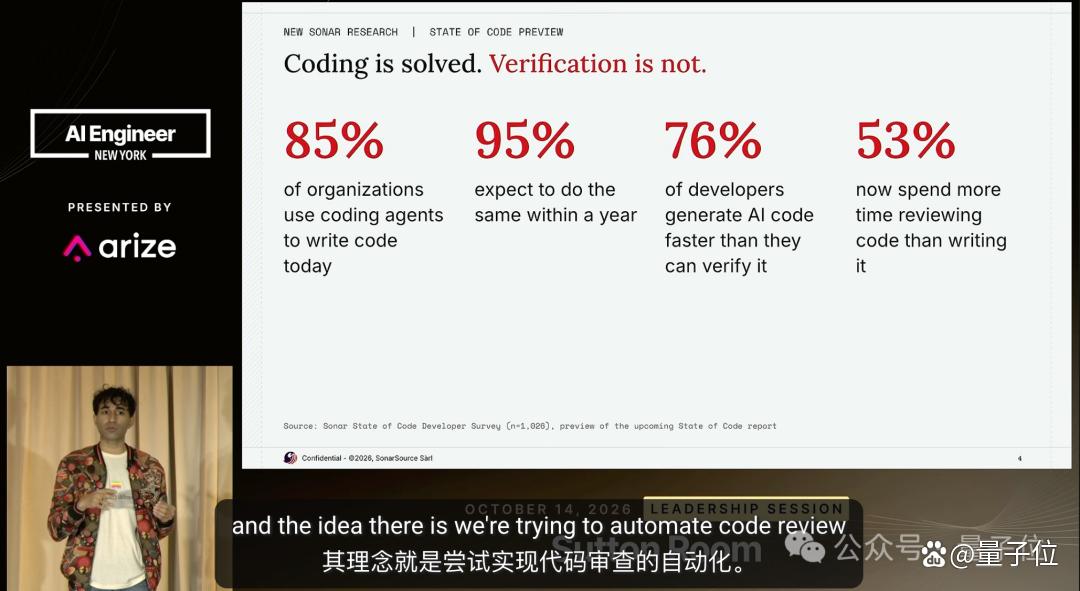
在最近一场对谈里,Anthropic的Addy Osmani介绍了他们的做法:
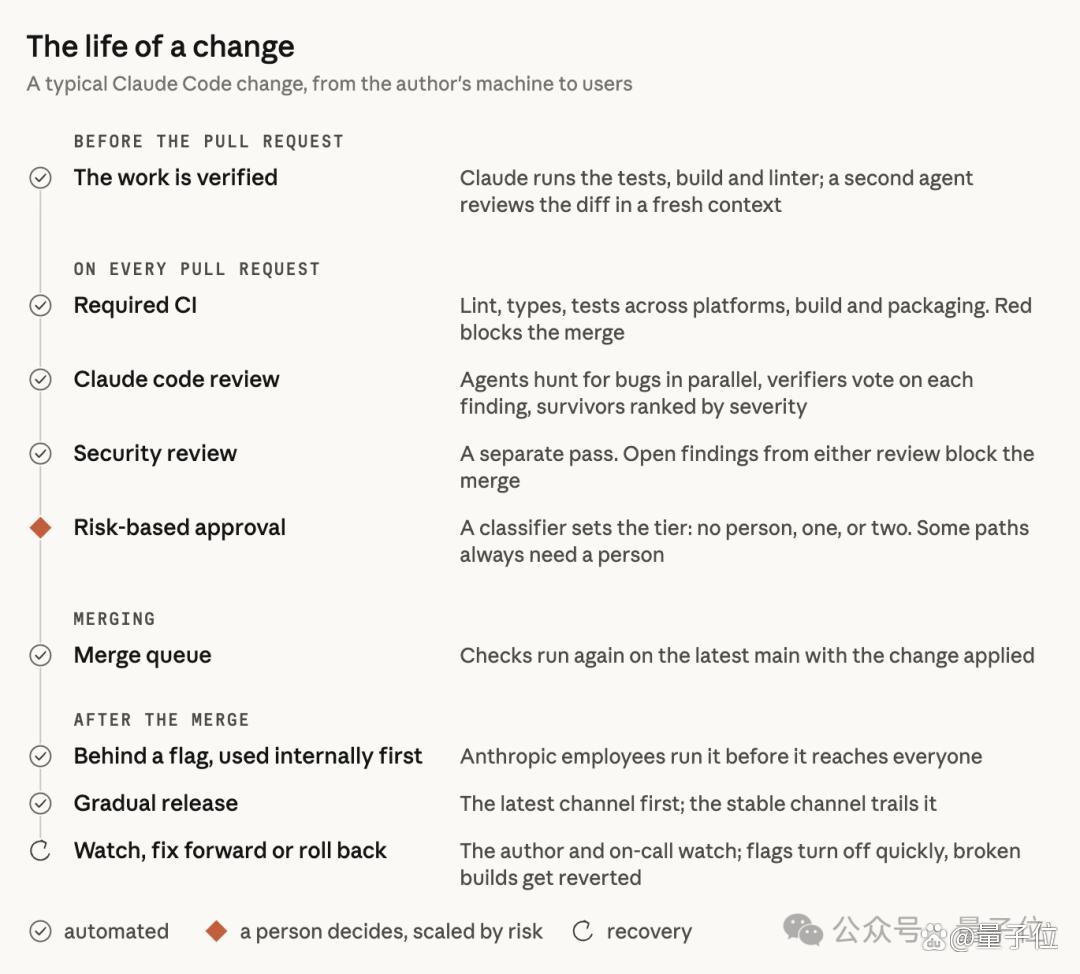
先让Claude做一轮审查,还要给它条件,像真实用户一样把功能跑起来。
 图片
比如改的是网页,就让它打开浏览器,检查页面、操作功能,再运行必要的测试。
工程师接着查看它交来的验证证据,包括操作录像、页面截图和测试结果。每项改动仍然有人负责,出了问题,负责人要去处理。
 图片
△Claude Code团队公布的代码改动检查与发布流程
Anthropic的工程博客里,还提到一个更麻烦的场景:
一轮测试运行期间,代码库里可能又合进了成百上千项改动。
在这样的规模下,团队发现,用仓库全局锁来协调合并队列的方式很难有效运行,于是把精力投向合并后、部署前的自动测试。
公司也承认,并发修改仍然可能发生冲突。
他们称,Claude通常能比人类发现冲突更快地完成修复,但没有披露相应的量化结果。
One More Thing
读到这你可能会觉得,那GitHub呢?
GitHub,其实也没闲着,自己也在重做底层。
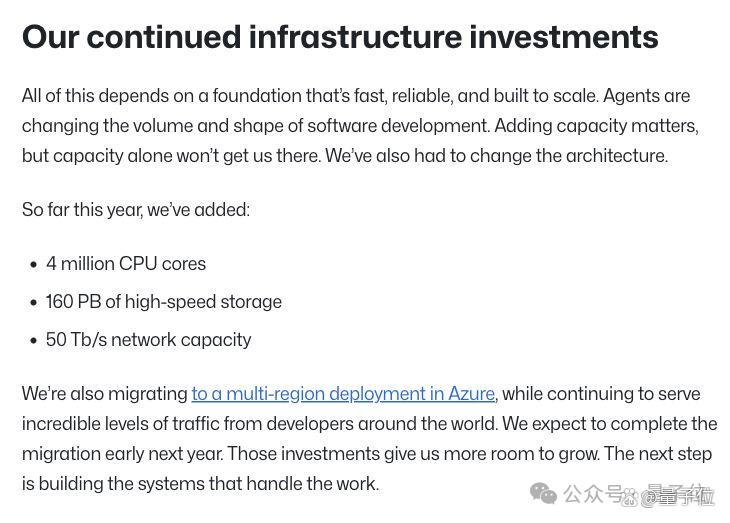
10月28日,它披露,今年已经新增400万个CPU核心和160PB高速存储,并继续把服务迁往Azure。
 图片
增加资源之外,原来的排队方式也得变化。
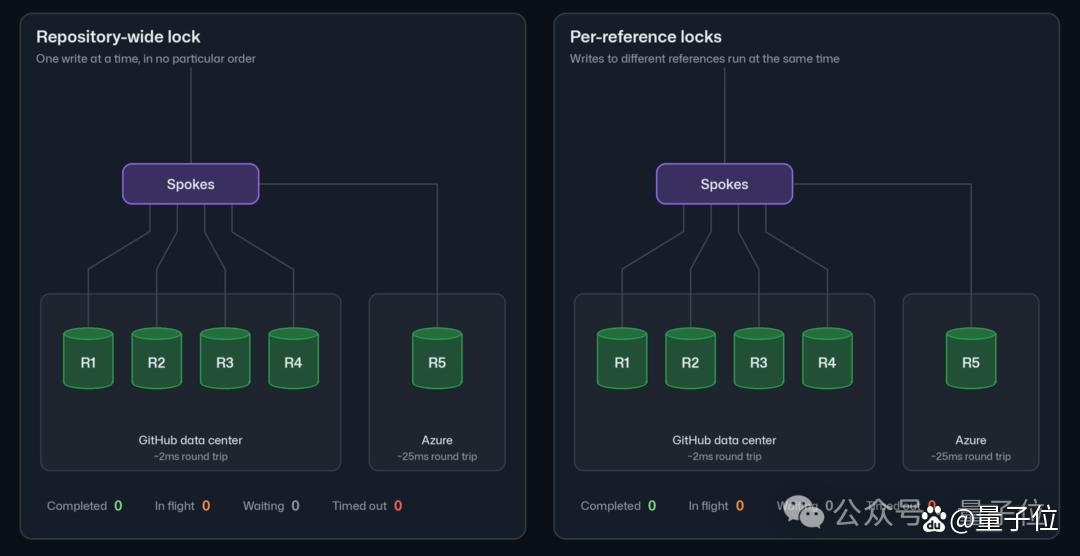
过去,即使几个Agent各自在不同分支上提交修改,仍可能在同一个仓库的写入环节相互等待。GitHub正在让这些更新能够并行处理,减少不必要的排队。
 图片
△左侧按整个仓库排队,右侧允许不同分支等引用的更新并行进行
代码存进去之后,还会有大量自动测试任务来取用。
GitHub也在把读取和写入所用的资源分开。来取代码的任务多了,就给负责读取的服务单独扩容,减少两边争抢资源的情况。
这些改造仍在分步推进。
OpenAI、Cursor开始自己提供代码托管,Anthropic重做内部系统;GitHub也在改造自己的基础设施。
所以说,大家都在应对AI带来的开发工作量。
至于咱们用的人嘛,要求倒也很简单:
代码写好了,该检查的也检查完了,准备合进去的时候,可别又给我出岔子啊……
 图片
参考链接:[1]https://x.com/FrenchBoulou/status/2117919227147640978[2]https://x.com/pierrecomputer/status/2117999036175188183[3]https://www.axios.com/2026/11/04/openai-pierre-computer-github[4]https://www.anthropic.com/research/redesigning-source-control[5]https://www.youtube.com/watch?v=AnsXWH2_EBU
举报/反馈
Interested in cooperating on this story?
We will get back to you within 1 business day