AI 提效 3 倍,交付为什么没快 3 倍:CTO 要重算的四笔账 Original en chino
引子:工具配齐了,交付为什么没快
工具配齐了,人也都用上了,交付还是那个速度。
AI 编程工具覆盖率 85%,公开报告写着代码生成效率提升 2–4 倍,团队自评也差不多。但从需求提出到上线的周期,只缩短了 12%。
还有两个更难看的数字:高级工程师更累了——他们现在要审的 diff 是过去的三倍;线上事故没变少,甚至因为变更更频繁而略升。
钱花了,工具买了,人数没减,交付没快。
问题不在 AI 不够强,也不在团队不够努力。问题在于:我们把一个系统级的问题,当成了一个工具级的问题来处理。
下面把它拆成四笔账。第一笔先算清楚——AI 的提速,到底去哪了。
一、第一笔账 · 提效账:提速去哪了
先把这个悖论算清楚。
一条需求从提出到上线,粗略经过七个环节:需求澄清、方案设计、编码实现、代码评审、测试验证、发布上线、线上观察。AI 直接作用的,只有第三个。
假设一个典型需求端到端 100 小时,编码占 30 小时。AI 让编码快 3 倍,30 小时变成 10 小时——省了 20 小时。看起来应该快 20%。
但真实传导是这样的:
三个衰减来源,每一个都不是编码速度能解决的:
衰减一:等待与交接(−1.2)
你写得再快,需求没澄清、设计没对齐,就得等。AI 生成的代码如果基于一个含糊的需求,产出的是更快产出的错误——而错误的代价要在下游才付。
衰减二:评审排队(−0.45)
这是最容易被忽略的一条。AI 让产出变快,但人类的验收速度没变。一个人一天能认真 review 的 diff 量是有上限的,产出翻三倍,队列就变成三倍长。
于是你会看到一个荒谬的现象:工程师编码时间从 30 小时降到 10 小时,但等评审的时间从 4 小时涨到 14 小时。个人效率提高了,团队吞吐没动。
衰减三:集成与验证拖尾(−0.15)
测试环境要排队、数据要准备、回归要跑、发布窗口有限。这些环节的产能如果没有同步扩张,就会变成新的收口。
这一节要带走的结论
AI 的提速是单点的,交付速度是系统的。用约束理论的话说:系统的吞吐由瓶颈决定,非瓶颈环节的任何改进,超过一定程度后都是浪费。所以 CTO 的第一个动作不是继续压榨编码环节,而是重新定位瓶颈在哪。
二、瓶颈不会消失,只会搬家
把七个环节的耗时在 AI 前后各测一遍,你会看到瓶颈的位置发生了迁移:
注意右半边的两个变化:
- 编码从 30h 降到 10h——这是 AI 的功劳,货真价实;
- 评审从 15h 涨到 20h,测试从 14h 涨到 18h——因为要验的东西变多了,而且 AI 生成的代码往往「看起来很对」,需要更仔细地看。
端到端 100h → 82h,快了 18%。这就是"3 倍提效"在系统层面的真实兑换率。
四个新堵点,按出现顺序
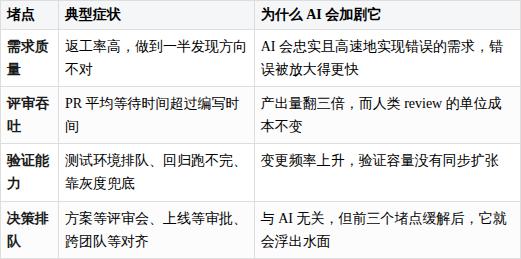
这四个堵点有个共同点:它们都不是"写代码"的问题,因此都不是靠换更强的模型能解决的。它们分别对应四个可以被 CTO 显式调整的系统参数。
三、CTO 能动的四个系统参数
约束理论给的步骤是:识别瓶颈 → 挖尽瓶颈 → 迁就瓶颈 → 提升瓶颈 → 回到第一步。落到研发体系上,对应四个可以显式调整的参数——入口口径、队列优先级、出口宽度、权限分布。
杠杆一:验收标准前移(动入口口径)
见效最快、阻力最小,一周之内就能做完。
做法是重写 DoD(Definition of Done)和 DoR(Definition of Ready),把过去那种「完成开发、通过自测」的含糊表述,换成可机读、可验收的清单。AI 时代至少要加这四条:
- 规格可机读:需求必须附带能被解析的验收条件(Given/When/Then 或等价形式),不接受形容词;
- 用例随规格生成:提交方案的同时给出测试点清单,AI 直接产出,人只做补漏;
- 埋点不可省略:新功能必须带关键指标埋点,否则上线等于盲飞;
- 影响面声明:明确写出这次改动触及哪些模块、需要谁知情。
这四条的共同点是:把"验收"从流程末端的检查,变成流程入口的准入条件。它不增加任何人的工作量,只是把工作挪到了更便宜的位置。
杠杆二:评审分层放行(动队列优先级)
这是四个杠杆里对交付速度影响最大的一个。
核心认识是:人类 review 时间是一项固定预算,不是无限资源。AI 把产出放大三倍之后,如果所有变更都过同一道人工闸门,闸门必然成为瓶颈,而且是人肉瓶颈——加班也解决不了多少。
解法是把变更按风险分级,机器能判的让机器判,人眼只留给真正需要的地方:
三条落地细节:
- 分级由代码所有者声明,不是由流程系统猜。声明错了会被事后抽检抓到,比漏审更容易纠偏。
- B 级的"自动放行"不是不审,而是换成机器审:静态扫描、依赖检查、覆盖率门槛、AI 交叉复核。人只做事后抽样。
- 给 S 级留足时间。目标占比 10–15% 意味着一个工程师每周可能只有 1–2 个 S 级变更,这两个值得花掉全部 review 预算的一半。
一个反直觉的提醒
很多团队第一反应是"AI 写的代码我不放心,全部都要人工看"。这等于把 AI 的产出优势原样抵销掉。信任不是靠全量人审建立的,是靠分级 + 事后抽检 + 变更失败率这个指标建立的。如果失败率在涨,收紧分级;如果稳定,放开 B 级。
杠杆三:验证能力并行化(动出口宽度)
评审和测试是相邻的两个瓶颈,只解决评审,压力会立刻转移到测试。
这里的关键不是"让测试也用 AI"(这是当然的),而是把串行改并行:
- 环境按需即开:预览环境随 PR 自动创建、合并即销毁,消灭"等我有个环境";
- 测试数据自动生成:过去造数据要等 DBA 或等脚本,现在可以用 AI 按 schema 生成脱敏数据集;
- 回归分层:快测(秒级)挡住 80% 的问题,慢测(分钟级)异步跑,不阻塞合并;
- 灰度即验证:把一部分验证成本从发布前挪到发布后,用流量染色和自动回滚兜底。
判断这个杠杆是否见效的指标非常直接:验证等待比(等待时间 ÷ 处理时间)。健康的系统这个值应该小于 1,AI 时代的团队很容易做到 3 以上——说明大部分时间都花在排队上。
杠杆四:决策下沉与自动放行(动权限分布)
前三个杠杆,团队内部就能推动。第四个不行——它必须由 CTO 本人推。
当一个组织的变更频率因为 AI 提升两倍以上,所有"需要某个人点头"的环节都会变成瓶颈,而且这类瓶颈最难被度量,因为它藏在日历里。
三条改法:
- 审批 SLA 化:任何需要人工拍板的环节都必须承诺时限(如"架构评审 24 小时内给结论"),超时默认放行或自动升级;
- 绿色通道:符合明确条件的低风险变更走自动放行,事后报备而非事前审批;
- 例外清单要显式写出来:把"哪些情况必须我本人看"写成一份不超过十条的清单,清单外的一律授权。这份清单的长度,直接反映组织的成熟度。
四、第二笔账 · 指标账:别用这四个假数字骗自己
AI 项目最容易自欺的地方,在于有大量看起来很美、实际上和交付无关的指标。
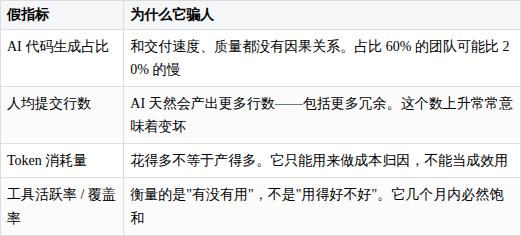
CTO 该看的是另外四组。它们在 DORA 四指标的基础上做了 AI 时代的扩展: