大模型出题总在胡诌?东南大学漆桂林教授团队 AutoQG 用知识图谱把每道题焊上证据链 Original en chino
摘 要
KER 2026 的 AutoQG:知识图谱 + 本体约束 + 多智能体,让科学问答可溯源,三元组 F1 达 72.3。
文末阅读原文可获取原文 PDF 和中文解读 PPT
一AI 读论文很溜,出题却总像在开盲盒
我们早已习惯让 AI 读论文:丢进去一篇 PDF,三十秒后拿到摘要、术语解释、方法总结,比咖啡凉得还快。可如果反过来让它出题呢?结果往往像让一位背熟了目录的读者去考专八——题干像模像样,答案却经不起追问。
科学论文不是百度百科。一个结论的成立,通常要跨越好几个章节:引言提出研究问题,方法说明怎么干,实验摆出数据,讨论又把结果和限制串在一起。直接让大模型对着全文出题,生成的问题很容易停留在事实复述,或者看似有深度,实则缺少可核验的推理依据。它可能会问「作者用了什么模型?」,却难以回答「为什么这个模型比基线更适合这篇论文的任务?」,更无法指出答案来自第几页第几段。
这种困境的根源在于,大语言模型并不天然理解科学论文的论证结构。它可以背诵术语,可以压缩段落,却很难把分散在不同章节的证据整合成一条完整推理链。于是生成的题目要么像百科条目,要么像阅读理解里的「找原词」,而不是真正的科学问题。
要让 AI 出题可用,评价体系必须升级。我们不能只看「问题是否通顺」,而要看「答案是否唯一」「推理是否跨章节」「证据是否能指回原文」。这正是 AutoQG 的出发点:把「出题」从语言生成任务,变成需要证据支撑的结构化推理任务。
2026 年 10 月,The Knowledge Engineering Review 在线发表了东南大学认知智能研究所所长、南京柯基数据首席科学家漆桂林教授的最新工作 AutoQG:automated evidence-traceable QA via ontology-guided KG。作者包括 Xiaoli Shen、Guilin Qi(通讯作者)、Peng Zhang、Dingsheng Yang、Yang Yang、Muyan Yang、Haowen Guo、Huikang Hu 等。
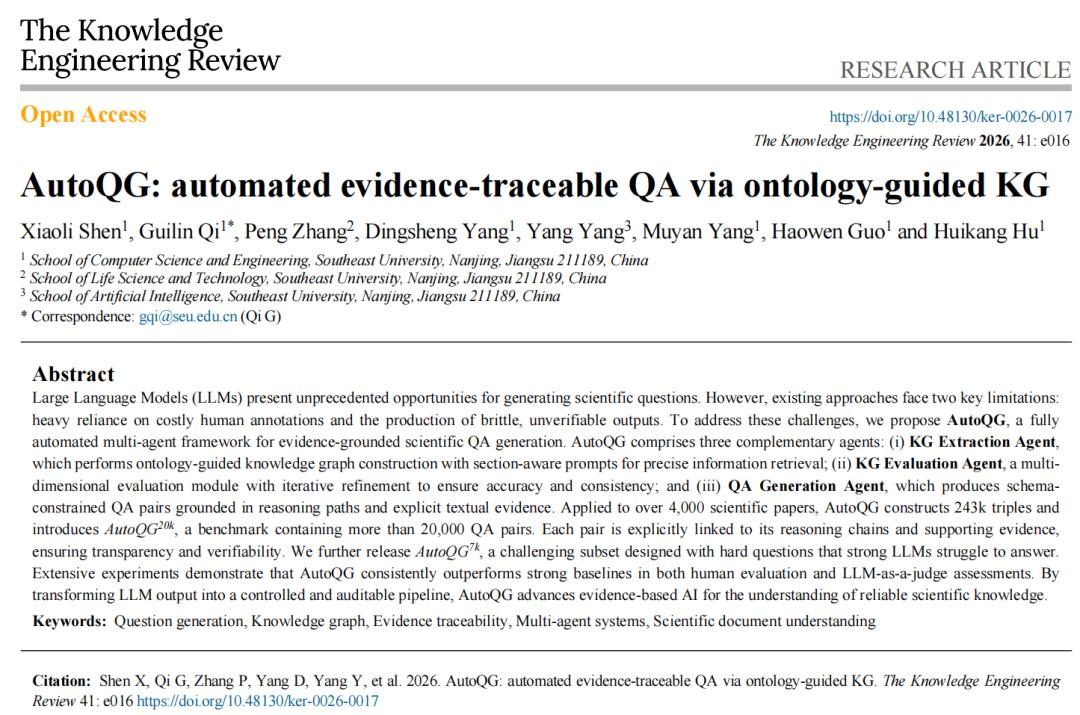
这篇论文试图回答一个更严酷的问题:AI 能不能在读完论文后,自动生成有深度、有依据、能指证原文出处的科学问答题?
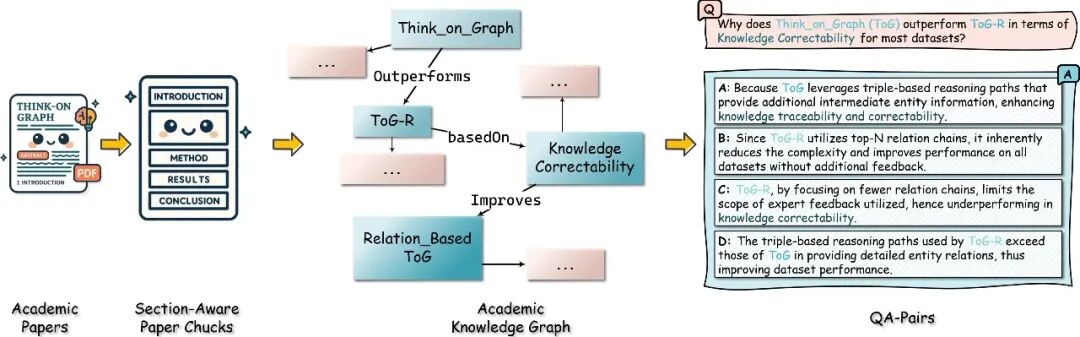
图1:AutoQG 端到端流水线:论文分块、章节感知、知识图谱、可溯源问答
二科学问答的命门:答案可以错,但出处不能丢
一道靠谱的论文级问答题,至少要同时过三道关。实体真实,题目里提到的概念、方法、数据集,确实出现在论文中。关系合法,实体之间的联系符合学科表述,不能硬把「提出」写成「改进」。推理有源,从题干到正确答案,每一步都能回到原文片段。
传统做法大致分两类。一类靠人工标注,质量高但贵到无法规模化;另一类靠端到端大模型直接生成 QA,速度快却像黑箱,题干和答案之间的「桥梁」往往不存在。模型可能从摘要里抓到一个名词,从结果段里抓到一个数字,然后把它们拼成一句看似正确的话。这种「跨章节拼贴」在开放式问答里尤其危险,因为答案没有明确的原文锚点。
更隐蔽的风险是幻觉迁移:模型把训练数据里的常识当成当前论文的事实。比如某篇论文只是引用 Transformer,模型就可能生成「作者提出 Transformer」这种错误题干。没有证据约束,出题就退化为语言模型的自由联想。
AutoQG 对这三道关的回应,是把证据从「可选附录」变成「系统骨架」。实体和关系先经过本体审核,再进入图谱;问题和答案的生成不是自由文本,而是从图谱上的推理路径导出。证据因此被锁定在生成过程的每一个环节。
AutoQG 的解决思路是:与其让模型直接从文本生成问题,不如先把论文变成一张结构化的知识图谱,再在图谱上出题。这样,问题、答案、推理路径和原文证据就被焊死在一条链上。这个思路把科学问答从「文本仿写」重新定义为「知识引导、证据约束的跨章节推理任务」。
三一张图看懂 AutoQG:三个智能体接力出题
AutoQG 的核心是一条 construct–evaluate–generate 流水线,由三个智能体分工完成。
KG Construction Agent(知识图谱构建智能体) 负责把论文拆成章节感知的文本块,在本体约束下抽取类型正确的三元组,并记录每条三元组对应的原文片段。它不会把「方法」段落和「结论」段落混为一谈,因为摘要、方法、结果、结论在论文中承担的语义角色不同。具体来说,它先做章节感知 schema 路由,再执行本体约束三元组抽取,随后完成证据映射,把每个三元组绑定到原文片段。
KG Evaluation Agent(知识图谱评估智能体) 从领域适配、准确性、一致性、完整性和粒度五个维度,对候选图谱做质量审计。发现缺失实体、关系冲突或证据不足,它会生成诊断反馈,把问题打回构建环节迭代修正。不是一次抽取就结束,而是抽完再验、验完再修。它的输出是一个通过验证的候选图谱,后续问答生成只能在这个「清白」的图谱上操作。
QA Generation Agent(问答生成智能体) 在通过验证的图谱中选择 1 至 3 跳的推理路径,把不同章节的证据聚合起来,生成有唯一正确答案的选择题。正确答案来自推理路径,干扰项也受到结构和证据约束。它还要保证每个选项、每条路径都能被回溯到原文,避免「看起来合理但查无实据」的选项混入其中。
三个智能体不是简单的串联,而是通过诊断反馈形成闭环。评估智能体发现的问题会返回到构建智能体,构建智能体修正后的图谱再进入下一轮评估。这种「构建—评估—再构建」的循环,是 AutoQG 能从 raw LLM 输出中挤出高质量中间表示的关键。
这套设计的妙处在于把「质量控制」从最终检验前移到中间产物。图谱如果不干净,问题一定答错;图谱如果证据缺失,问题一定无法溯源。先把图谱做扎实,后面的问答生成自然水到渠成。
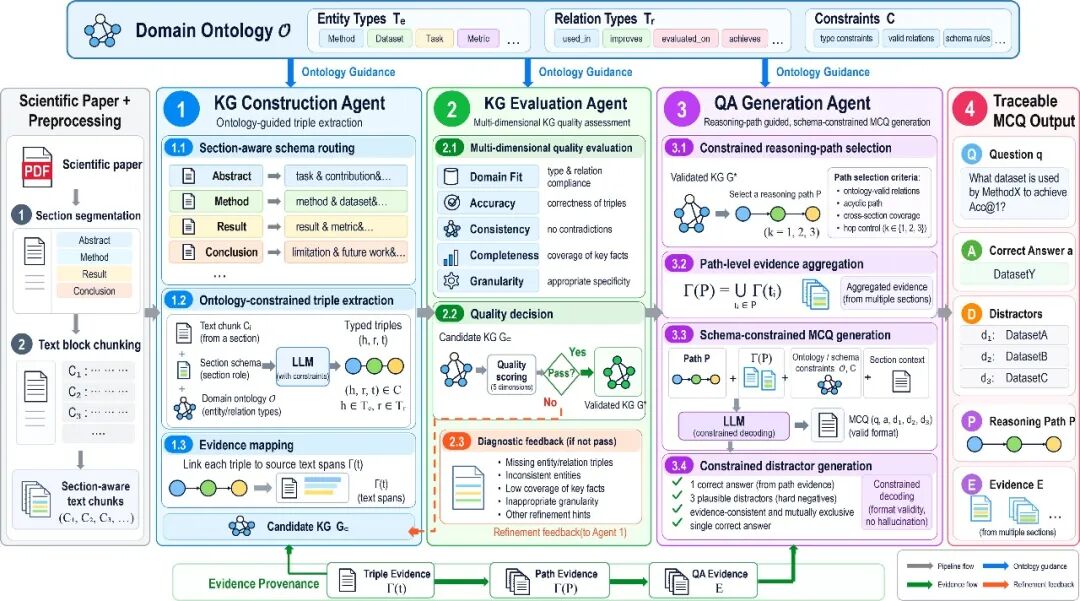
图2:AutoQG 三智能体框架:构建、评估、生成,证据流贯穿全程
四本体不是装饰品,而是给关系和实体定规矩
AutoQG 和一般「大模型 + RAG」方案的最大区别,在于它显式引入了领域本体。RAG 通常只是从论文中检索相关段落,再把段落塞进 prompt;AutoQG 则用本体规定哪些实体类型合法、哪些关系可以被建立、什么样的三元组才算合理。
论文构建的 AutoQG 本体把科学话语拆成 8 个核心类别:Method(方法)、Usage(使用)、Evaluation(评估)、Result(结果)、Comparison(比较)、Component(组件)、Data(数据)、Concept(概念)。每个类别下再展开 800 多个细粒度关系,例如 uses、evaluatedOn、outperforms、consistsOf、trainedOn 等。在论文图 3 的关系分布中,Method 占 23.4%,Usage 占 18.7%,Evaluation 占 15.2%,Comparison 占 10.3%。
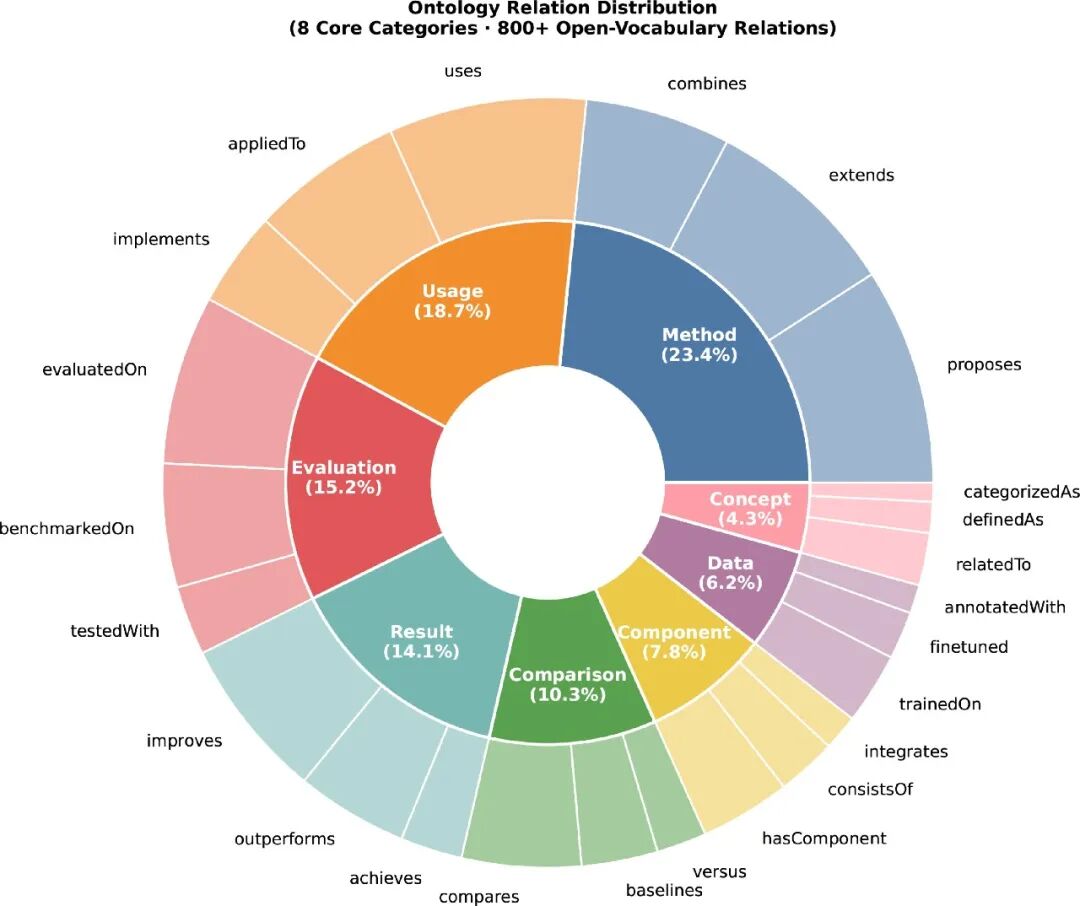
图3:AutoQG 本体的关系分布:8 个核心话语类别 + 800 多个细粒度关系
本体的存在让 LLM 不再是「自由联想」。当一个实体被识别为「方法」、另一个实体是「数据集」时,模型知道 evaluatedOn 是合法关系,而 improves 则需要额外证据。这种约束把抽取错误率压下来,也让后续生成的 QA 有章可循。更关键的是,本体定义了模式约束解码:在生成问题和选项时,模型不能随意编造关系,而必须从预定义 schema 中选择。这就好比给生成器加了一份「关系白名单」。
这套本体不是手工逐条硬编码的 800 条规则,而是从大量论文中统计、归纳、再精炼出来的科学话语模式。它既保留了学科通用性,又通过开放词汇关系覆盖了不同领域的特殊表达。对知识图谱工程来说,这是「自上而下 schema」和「自下而上统计」的较好结合。
五章节感知:论文不是一锅粥,而是有结构的证据仓库
科学家写论文有固定「地形」:摘要给全景,方法给操作,结果给数据,讨论给解释。AutoQG 的 KG Construction Agent 在分块时会先判断每个文本块来自哪个章节,再按章节角色决定抽取策略。
同一个术语在不同章节里的语义权重并不一样。比如「数据集」在方法段出现,通常意味着它被用于训练或评估;在相关工作段出现,可能只是被提及。章节感知处理让三元组不仅正确,而且定位准确。摘要里的贡献声明、方法里的操作步骤、结果里的性能数字、结论里的未来方向,各自对应不同的实体类型和关系集合。
更关键的是,每个三元组都带有一个 evidence provenance(证据溯源)——即原文中的文本片段。于是,从三元组到路径、从路径到问题答案,每一步都能指出具体证据。问答的可追溯性因此不是后处理贴标签,而是从抽取阶段就嵌入结构。这种设计在后续的 QA 生成阶段被反复调用:当模型生成一道题时,它能同时给出支撑这道题的原文区间。
证据溯源还有一个常被忽略的好处:它让人工校验变得可行。如果一道题的答案看起来可疑,研究者不需要重新跑整个系统,只需要沿着 evidence provenance 回到原文片段,就能判断是图谱抽错、路径选错,还是问题本身有歧义。
六迭代评估:抽到第三轮,质量反而最高
KG Evaluation Agent 的另一个重要设计是迭代精炼。它不会只评估一次就放行,而是多轮打分、反馈、修正。论文实验显示,第二轮和第三轮的质量曲线明显不同:第三轮 KG 质量达到 8.30,QA 质量达到 9.30,同时 80% 的图谱通过阈值;到了第四轮,质量反而下降,出现过度精炼。
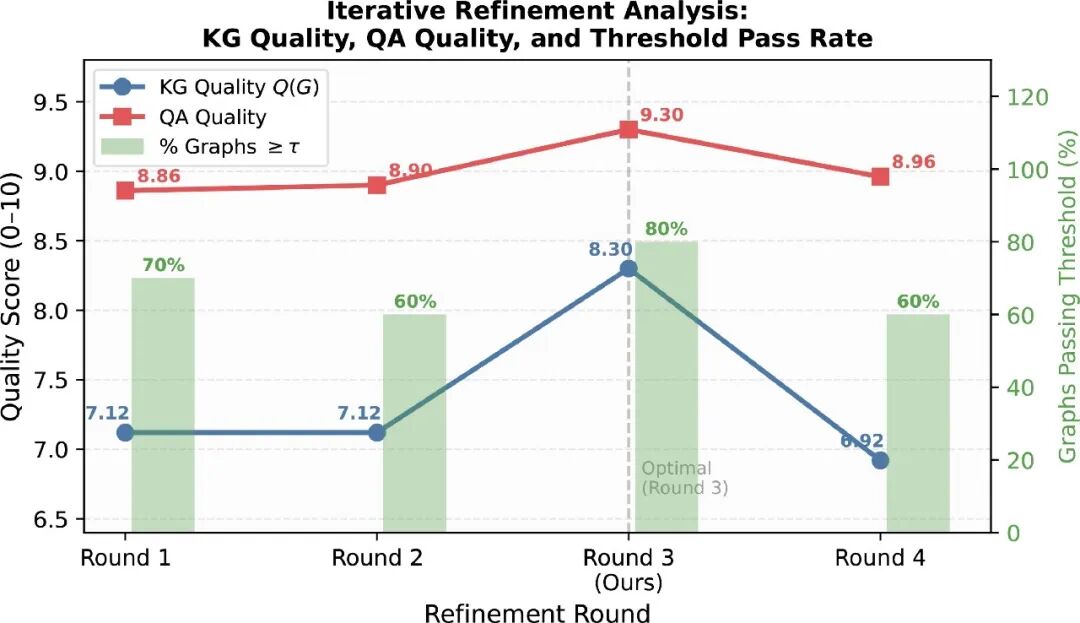
图4:迭代精炼曲线:第三轮(Round 3)KG 质量 8.30、QA 质量 9.30、通过率 80% 为最优
这个倒 U 型曲线说明,智能体之间的反馈循环并非越多越好。第三轮是 AutoQG 默认配置,因为它在图谱质量、问答质量和通过率之间取得了最佳平衡。这种「知道何时收手」的设计,在自动化流水线里尤为难得。过度精炼的副作用也不难理解:反复修正可能把原本合理的近似关系磨掉,或者让图谱过度迎合评估标准而失去多样性。
这一发现对多智能体系统的设计有普遍启示:反馈循环需要止损点。不是每增加一轮迭代都会带来质量提升,系统必须能够判断什么时候继续修正会得不偿失。
AutoQG 把第三轮作为默认配置,不是拍脑袋,而是基于质量、通过率和成本的综合权衡。这种数据驱动的配置选择,让系统在实际部署时更稳定,也更容易被研究者复现。
七从 4,435 篇论文到 24 万三元组:两套基准的来历
AutoQG 不是小打小闹的概念验证。研究团队把它跑在 4,435 篇科学论文上,最终构建出 243,214 条知识三元组,并基于这些三元组生成两套证据可追溯的问答基准。
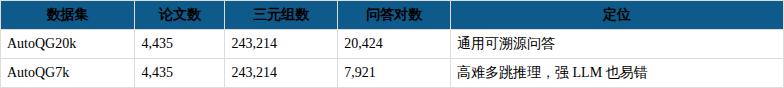
AutoQG20k 覆盖 20,000 多组问答,用于常规训练和评测;AutoQG7k 则专门保留那些需要多跳推理、对当前大语言模型更有挑战的问题。每一组问答都附带推理链和支持证据,而不是孤零零的「问题—答案」对。这种带结构的数据,比传统 QA 数据集更接近科研阅读的真实需求。
AutoQG7k 的难点在于它要求模型把多个三元组串起来。一道题可能需要先定位方法,再找到该方法在哪些数据集上被评估,再比较不同数据集上的结果。这种多跳推理对当前强 LLM 依然构成挑战,也正是这个子集让后续的微调实验产生了 34.4 个百分点的提升。
两套基准的分化设计,让 AutoQG 既能服务日常科普性问答,也能挑战强模型的科学推理天花板。20,424 对保证覆盖面,7,921 对保证深度,二者合起来构成了一条完整的评测谱系。研究者可以根据任务难度,灵活选择训练集和测试集的组合。
八数字说话:72.3 的 F1,9.8 的可信度
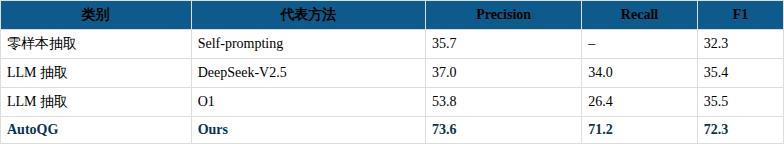
在 30 篇人工标注论文的评测中,AutoQG 的知识三元组 F1 达到 72.3,远超最佳直接大模型抽取基线的 37.0。这个差距不是小数点后的微调,而是接近一倍的提升。
人工评价维度包括答案正确性、推理深度和证据可追溯性。AutoQG 在这三项上分别达到 9.8、8.4、9.7(满分 10 分)。更有趣的是消融实验:去掉本体约束后,推理深度下降 3.5 分;去掉迭代反馈,推理和证据可追溯性同时下滑。这再次证明,本体和评估反馈不是可选模块,而是整个系统的承重墙。
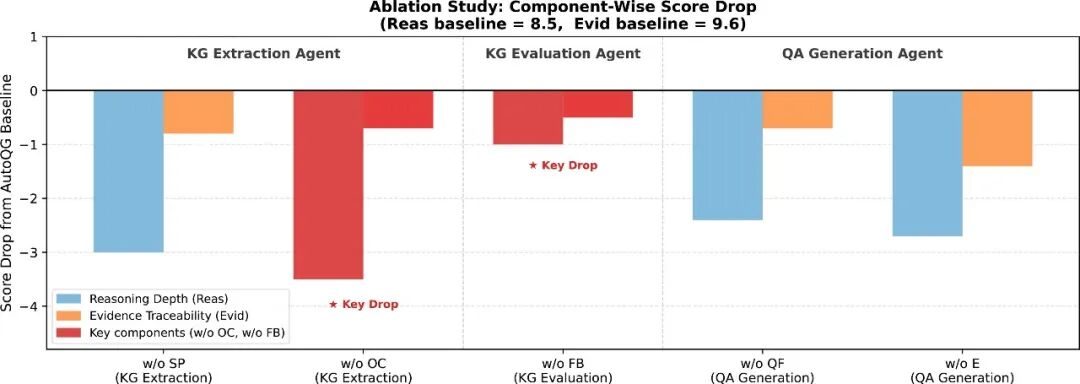
图5:消融研究:去掉本体约束(w/o OC)对推理深度打击最大,迭代反馈(w/o FB)同时影响推理和证据可追溯性
从这张表还能读出另一个信息:AutoQG 的优势不是单靠某个模块,而是结构化约束 + 迭代评估 + 证据映射的协同。拆掉任何一个关键组件,整体质量都会明显下滑。这说明高质量的科学问答无法靠单点突破,必须依赖系统性的中间表示。
人工评分中的 9.7 分证据可追溯性尤其值得关注。它说明用户不仅能得到正确答案,还能接受答案背后的证据链。这种可审计性在科学研究、医学证据、法律文献等高 stakes 场景中尤为重要。
九反哺训练:Qwen2.5-32B 从 44.9% 飙到 79.3%
AutoQG 的价值不止于生成评测题。研究团队用 AutoQG7k 对 Qwen2.5-32B 做微调,模型在推理评测上的准确率从 44.9% 提升至 79.3%,增加了 34.4 个百分点。
这些训练样本的特殊之处在于,它们不只是「题面 + 正确答案」,还附带从条件到结论的推理路径,以及路径上每一步对应的原文证据。模型学到的不是死记硬背,而是带着地图走路:先找证据,再推答案。路径级别的证据聚合把不同章节的片段拼成一条完整逻辑链,这对训练科学推理模型尤为重要。
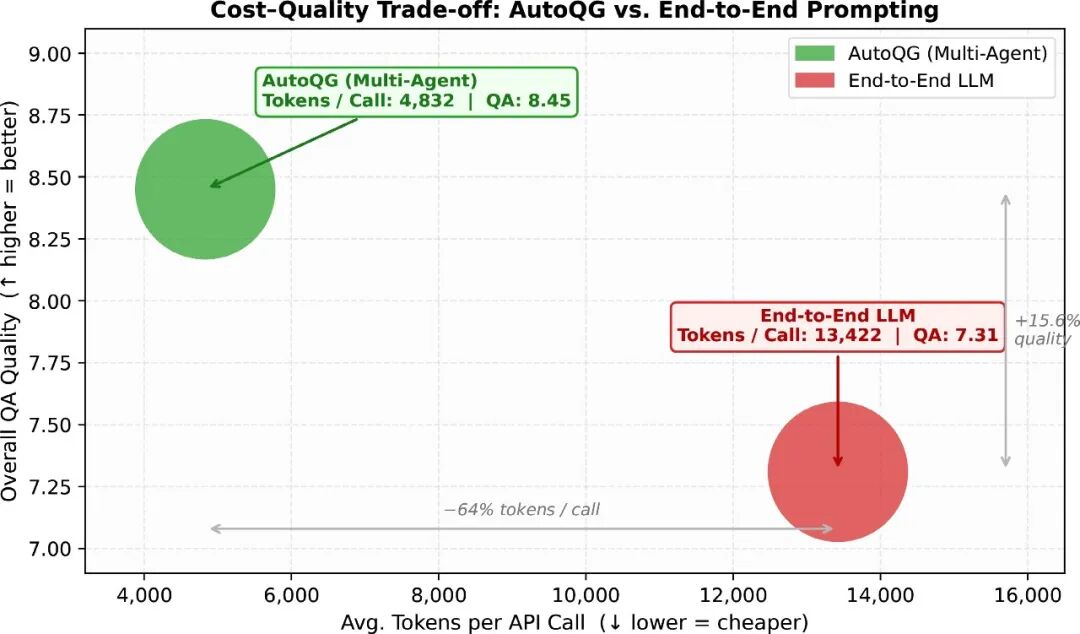
图6:成本—质量权衡:AutoQG 每调用仅需 4,832 token,QA 质量 8.45;端到端 LLM 需 13,422 token,质量 7.31
成本上,AutoQG 平均每次 API 调用仅需 4,832 token,QA 质量 8.45;而端到端大模型需要 13,422 token,质量却只有 7.31。结构化的多智能体流程不仅更准,还更便宜。这个结论对实际部署很有意义:与其让一个大模型无限制地「自由发挥」,不如用几个小模型在结构化图谱上做精确定位。
34.4 个百分点的提升也说明,训练数据的质量比数量更重要。7,921 道高难度但带证据的题,胜过数十万道浅层问答。这为科学推理模型的数据构建指明了方向。
成本和质量的双重优势,让 AutoQG 在大规模文献处理场景中具备实用价值。对于一个需要批量处理成千上万篇论文的机构来说,token 开销的下降会直接转化为可承受的运营成本。
十还没做完:跨论文和多模态是下一步
AutoQG 目前仍以单篇论文文本为主要处理单元。研究团队坦承,跨论文引用关系、图表、公式等多模态信息还没有被充分纳入。它现在能回答「这篇论文里说了什么」,但还难以回答「这篇论文的结论在另一篇论文里是否被推翻」。
这个局限恰恰是下一步的攻关方向。如果把引用网络、论文中的表格曲线、甚至补充材料里的公式都变成可查询的知识,AutoQG 就能从「单篇阅读助手」升级为「文献综述协作者」。对科研工作者来说,这意味着 AI 不只是总结论文,还能追问:这个结论凭什么成立?别人又是怎么验证的?未来的系统也许能追踪一个方法从提出、改进、质疑到被取代的全过程。
另一个值得关注的方向是多模态理解。论文中的图、表、公式往往承载着关键证据,而这些非文本信息目前被 AutoQG 排除在外。如果能把图表解析成结构化断言,AutoQG 的出题范围将从「文本段落」扩展到「全文证据」。
这些扩展不会削弱 AutoQG 的核心贡献,反而会放大它的价值。本体约束和证据溯源的框架,天然可以容纳跨文档引用和多模态证据。只要能把它们表达成三元组或超关系,整个流水线就能继续运转。
从这个角度看,AutoQG 不只是做了一个自动出题工具,更提供了一种把大模型输出「结构化和可审计化」的通用思路。
十一科研阅读的新读法:从「看完」到「问到底」
AutoQG 提供了一种新的阅读辅助方式。它不再把大模型当成一个会总结的复读机,而是让它扮演一个会追问、会举证、会指出证据出处的审读人。
把分散在论文各处的信息组织成可检查的知识与证据链,这件事对知识图谱、科学问答和科学推理模型训练都有长远价值。当 AI 生成的每一道题都能被追溯到原文,科学研究的可重复性和可审计性就多了一层保障。论文、数据、模型之间的闭环,也许就从一张「可溯源的知识图谱」开始。
下一次当你读完一篇论文,不妨试试让 AutoQG 这类系统给你出三道题。如果它能答出答案,还能指出证据在原文哪里,那才算真正读懂了这篇论文。
对知识图谱从业者来说,AutoQG 也提供了一个值得关注的信号:本体和大模型不是互相替代,而是可以互相约束、互相放大。本体给大模型定边界,大模型给本体补实例,二者协同才能做出可审计、可复现的 AI 应用。这条路径在科研、医学、法律等需要证据链的领域尤其值得深耕。
标签:知识图谱 · 科学问答 · 本体论 · 多智能体 · 证据溯源