万亿级市场表征:从1Hz微观结构到金融世界模型的新路径 Original en chino
“Towards Financial World Modeling”
金融市场是一个高度高维、嘈杂且由异质参与者构成的复杂系统。构建一个能够支持规划与决策的“世界模型”,需要从繁杂的交易数据中提取兼具预测价值与结构意义的表征——既要知道未来收益、波动率与流动性如何演变,也要理解市场在何种维度上被组织。然而,现有的金融表征学习往往局限于单一任务、窄时间段或小样本数据集,难以支撑对市场机制的深层建模。
本文提出三项核心贡献,为金融世界模型奠定基础:其一,发布Market-1T数据集,涵盖2008至2025年间美国上市股票近一万亿个一秒级观测值,时间跨度接近二十年,远超现有公开基准;其二,设计系统性评估协议,在32个随机采样月份上考察不同市场体制下的表征性能,并引入对潜在结构的显式探针;其三,在统一架构上比较18种编码器训练策略,揭示预测性能与潜在组织之间的复杂关系。
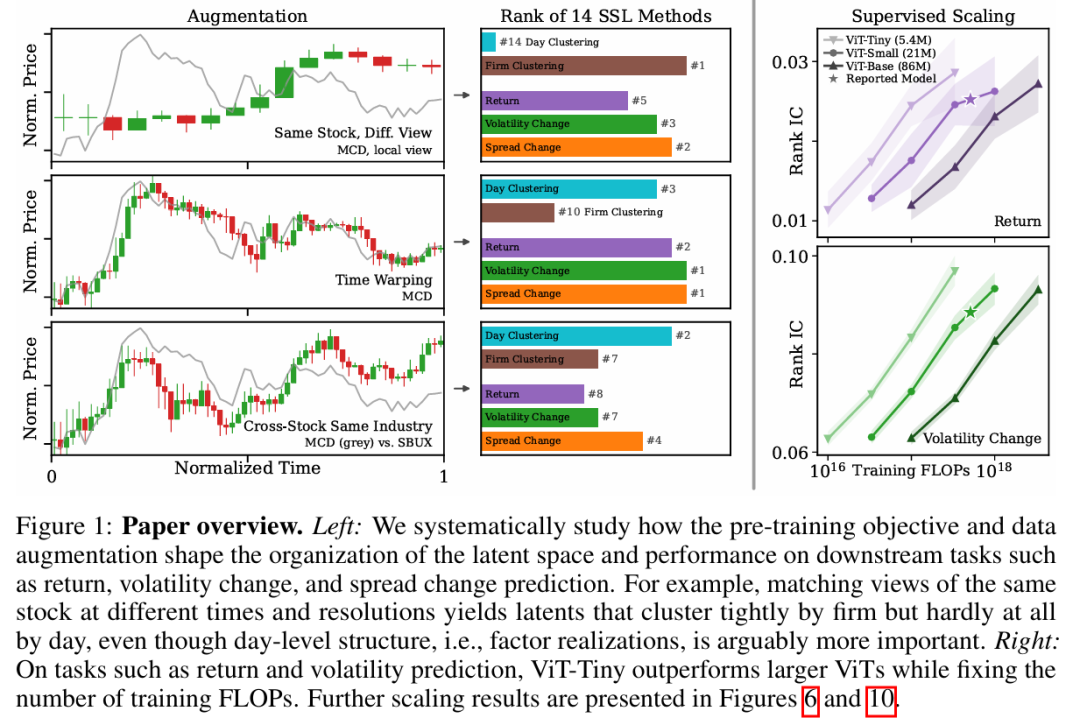
研究发现,不同训练目标对市场状态的组织方式差异显著:有的强调公司身份记忆,有的偏向市场整体运动;且预测有效性并不必然与结构保留一致。这提示我们,单一指标无法衡量表征质量,而未来的金融世界模型需要多维度、跨体制的表征基础。
【 扫描文末二维码加入星球获取论文,源码 】
摘要
构建世界模型需要一个对规划和决策有用的状态表征——可能涉及训练时未知的任务。在金融市场背景下,规划和决策可能需要模型推理市场整体状况、资产特定预期收益、流动性、波动率以及跨资产关系。然而,金融表征学习很大程度上是在单个预测任务上评估的,往往使用较窄的数据集在单一时间段上进行评估。
本文通过三项主要贡献解决这一问题。首先,我们引入Market-1T,一个包含2008年至2025年美国股票近一万亿观测值(1 Hz分辨率)的数据集。其次,我们开发并实施严格的评估协议。第三,我们对金融表征学习进行系统性大规模研究,比较了18种编码器训练策略,跨越近二十年的市场体制。我们通过常见金融任务的预测效用和潜在结构探针来评估学习到的表征。我们发现,预测性能相似的编码器对市场状态的组织方式可能非常不同。总体而言,我们为训练和评估金融市场表征奠定了基础,以支持DINO-WM、V-JEPA 2和LeWM等世界模型。
简介
金融市场在促进风险分担、提供流动性和聚合信息方面发挥关键社会作用。监控和理解市场并采取相应行动对维持正常运作的经济和社会至关重要。这种决策的关键是一个可用于探索反事实结果并优化事前决策的模型,即"世界模型"。
虽然金融市场对现代经济至关重要,但它们也是高度高维、嘈杂、地理分散的,并由异质参与者组成。例如,单一资产一天的状态可能涉及数十个交易场所的特定价格和数量的数百万买卖报价,以及来自不同参与者——有些是人类,有些是机器——具有不同激励的交易。金融市场的世界模型因此需要一个能够在高度随机环境、多变市场体制、目标以及可能训练时未知的任务下实现规划和决策的状态表征。
然而,金融市场的表征学习历史上一直集中在:i)训练时已知的相对狭窄任务和/或 ii)市场有限的时间或资产切片。我们通过三项主要贡献迈出发展金融世界模型的第一步:
Market-1T:我们引入一个公开可用且许可宽松的数据集,包含2008年至2025年所有美国上市股票的一秒报价和交易聚合。Market-1T包含近18年近一万亿观测值,比典型公共金融表征学习基准具有更长的历史跨度与更细的时间分辨率,使得可以在异质市场体制中反复重新训练和评估方法。
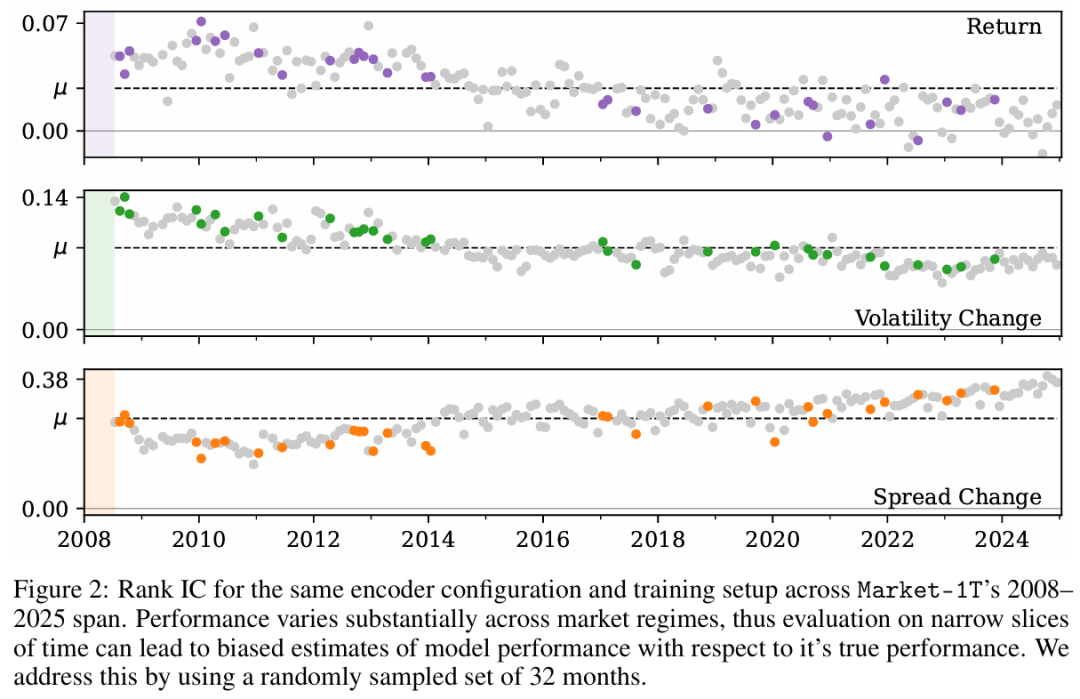
严格评估协议:我们仔细检查评估协议对探针样本量、市场体制、模型规模、表征年龄以及用于将预测转化为交易的组合构建选择的敏感性,主要使用监督基线进行探索。我们的最终评估策略使用2008-2025年间的32个月,训练限于前置数据,超参数选择独立于最终评估期间。
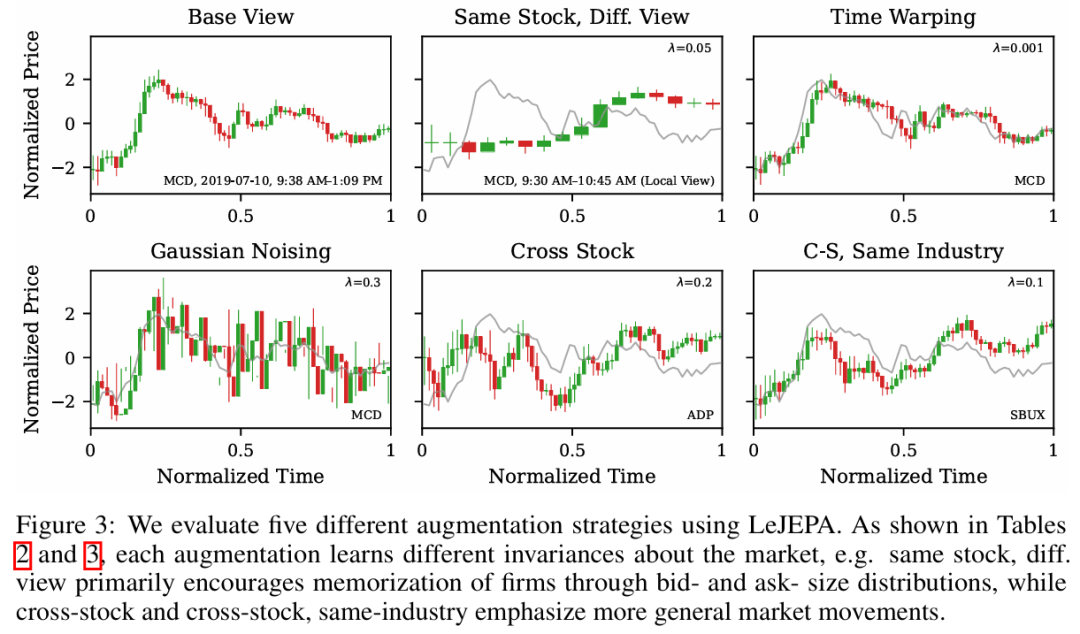
金融领域SSL探索:我们在公共架构和评估协议下比较了14种自监督编码器训练策略,变化数据增强和预训练目标。这些编码器可构成LeWM、DINO-WM或V-JEPA-2风格世界模型的基础。我们既询问学习是否保留了关于未来收益、波动率和流动性的信息,也询问所得潜在空间保留了什么具有经济意义的结构。
相关工作
世界建模
现代世界建模方法在状态表征获取方式上有所不同:DINO-WM在预训练编码器之上学习动态,V-JEPA 2将预训练预测编码器适应于动作条件预测,LeWM可以联合学习或微调表征与下游动态。我们的实验聚焦于这一表征层:此处研究的金融编码器可以插入这些方法作为候选状态表征,可冻结或与动态模型联合微调。
金融表征学习
金融表征学习工作通常主要通过未来预测或较窄的下游分析进行评估。这包括通用时间序列预测模型如PatchTST和Chronos,高频模型如DeepLOB,以及金融特定预训练模型如DELPHYNE和Kronos。现有自监督工作考虑了对比资产嵌入、股票相似性和组合构建的表征、组合多样化的特征、以及重构性限价订单簿表征,以及基于JEP的潜在市场状态表征。相比之下,我们在统一的多体制协议下系统比较了广泛的监督、自监督和预训练编码器,同时评估有关未来市场演变的信息和学得潜在空间中具有经济意义的结构。
金融数据集和基准
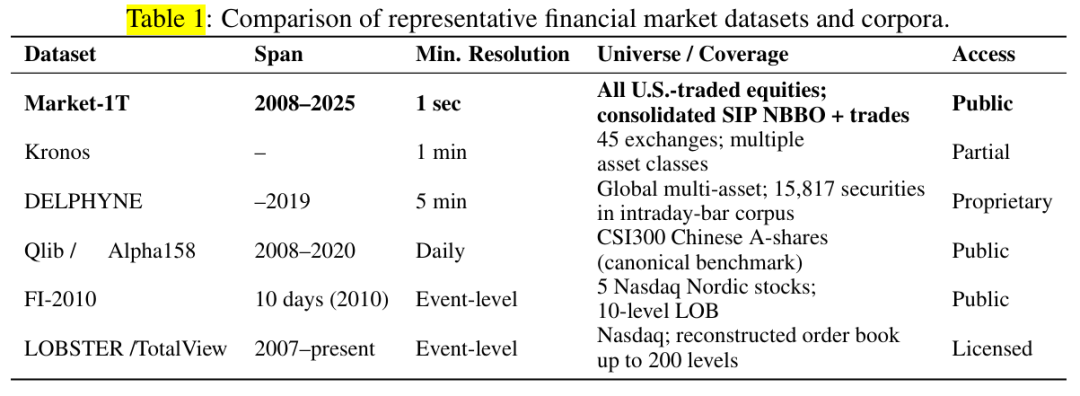
现有金融数据集在规模、频率、覆盖范围和可用性方面差异很大。公共基准包括日频量化股票数据集如Qlib/Alpha158,而高频工作通常依赖专门的限价订单簿数据集和任务,包括DeepLOB和SimLOB使用的那些。最近金融特定预训练模型如DELPHYNE和Kronos使用了大得多的话语料,但这些数据是专有的或仅部分发布。LOBSTER/TotalView在精神上最接近Market-1T,尽管它按事件级别组织并要求昂贵许可。Market-1T在时间和横截面维度上大幅扩展了公共设置,包含2008-2025年间美国上市股票变化宇宙中近一万亿个一秒聚合。其高时间分辨率、广泛市场覆盖和长历史跨度的组合使得可以在许多市场体制中进行因果时间评估,而不是在固定宇宙或短近期时间段上评估。
数据集
构建和评估金融世界模型需要同时捕获细粒度市场动态和跨市场体制发生的实质性分布变化的数据。为此,我们与Massive合作构建Market-1T,一个覆盖2008至2025年美国市场交易的所有股票的数据库。宇宙包括美国公司和非美国公司但股权在美国交易所上市的公司。我们从2008年开始,这是Regulation NMS采用后的第一个完整年份,该规则显著改变了美国交易报告要求。在全部样本中,数据集包含近一万亿个一秒聚合。
来源和时间分辨率。 Market-1T由Massive分发的合并美国股票报价和交易数据构建,包括来自合并磁带协会(CTA)和未上市交易特权(UTP)计划的证券信息处理器(SIP)源。底层数据由NBBO更新和合并交易报告组成。我们将这些异步事件聚合为同步一秒观测值。
我们使用1 Hz作为基础分辨率,因为它保留了细粒度订单簿和交易动态,同时支持向更粗糙时间范围的精确聚合。模型因此可以在不依赖插值的情况下,以从秒到分钟或更长的时间范围查看同一底层市场历史。对于每个一秒间隔,订单簿字段记录间隔结束时最后有效报价状态,而交易字段汇总该间隔内发生的合格交易。
跨分辨率,每个观测值包含相同11个特征:
订单簿状态:最优买价和卖价及尺寸(P_bid, S_bid, P_ask, S_ask)
价格摘要:开盘价、最高价、最低价、收盘价和成交量加权平均价格(VWAP)
活跃度:交易量(V_vol)和交易数量(N_count)
基准宇宙。 虽然Market-1T包含完整美国交易股票宇宙的数据,我们的基准实验使用相对流动的普通股宇宙。关键是,宇宙每月单独重新计算,仅使用前一个月可用的信息,避免幸存者和前视偏差。证券必须是普通股,前月平均VWAP高于5美元,平均日美元交易量至少2000万美元,并在超过20%的常规交易秒内有交易活跃度。这产生变化的横截面,而非存活到样本末端的固定公司列表。发布的元数据支持重现此宇宙以及构建替代宇宙。
训练聚合。 1 Hz表征还允许我们使用标准金融聚合规则在不同有效时间尺度构建视图。对于每个输出间隔,我们(i)取最后有效的买卖状态,(ii)计算开盘、最高、最低和收盘交易价格,(iii)计算VWAP,以及(iv)求和交易量和交易数量。我们在随机缩放和裁剪增强中使用此操作,允许同一资产-日的不同视图覆盖不同时钟时间量,同时保留市场聚合的语义。
训练标准化。 我们按经济类型标准化特征。所有价格相关特征使用共同均值和标准差联合标准化,在观测值内保持相对排序。买卖尺寸使用log(1+x)变换然后联合标准化。交易量和交易数量分别用log(1+x)变换和标准化。所有标准化统计量仅从训练数据估计。
评估
方法
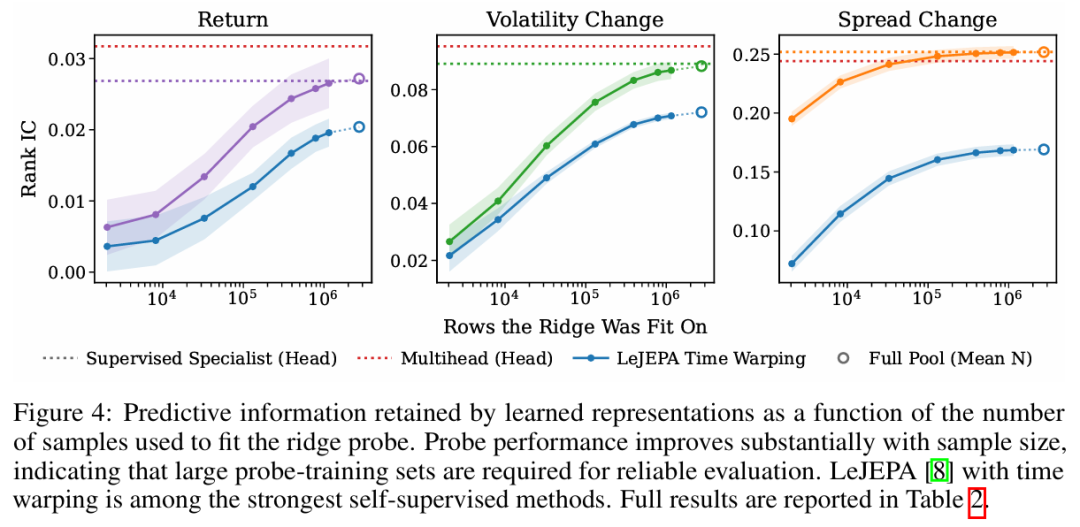
我们在2008-2025年采样的相同32个月上评估每个方法。对于每个评估月,模型仅使用前六个月的训练数据(时间序列基础模型除外)。我们尽可能跨方法标准化架构、计算、预处理和探针拟合。因为探针质量高度样本依赖(图4),所有最终结果使用完整探针训练池。我们变化SSL的预训练目标和增强,使用标准化两阶段超参数优化程序,在五个单独调优月上执行。所有图呈现2标准误差条,SE计算调整月间方差。
预测信息
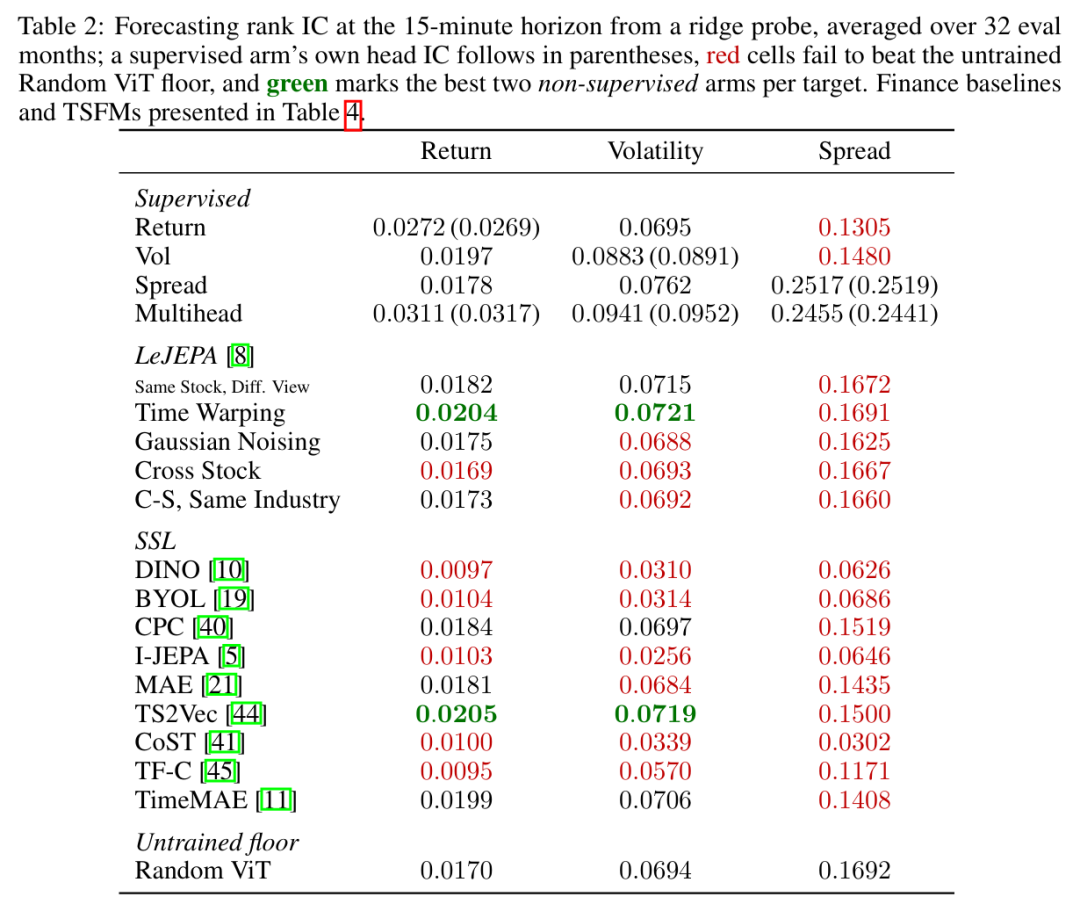
我们的第一个评估询问学得表征是否保留关于未来市场状态的信息。我们使用岭探针探测未来收益、波动率变化和买卖价差变化的表征。我们使用排名信息系数(IC)测量预测信息,将收益定义为视图结束后一分钟到视图结束后15分钟开始的VWAP变化。具体为:
IC = Spearman相关(预测收益, VWAP(t+900, t+960)/VWAP(t, t+60) - 1)
核心结果在表2中呈现。监督训练在多个目标上保留的预测信息显著高于自监督目标。联合监督多头训练对收益和波动率变化特别有效,表明这些量共享可被公共表征利用的预测结构。价差变化行为不同:多头模型从任务溢出略为退化,所有SSL方法表现低于未训练编码器,表明价差预测相关信息相对专门化。
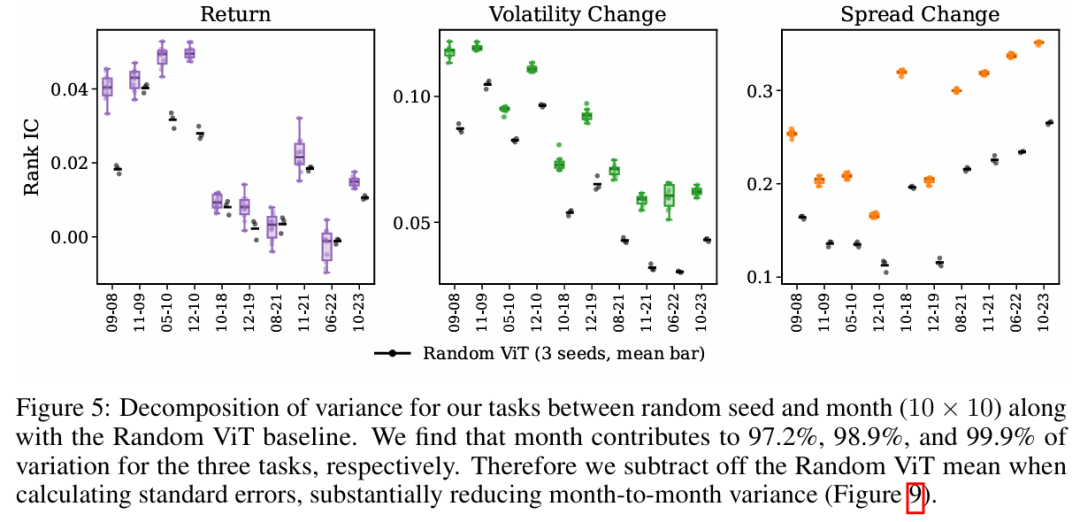
与未训练编码器的比较也很重要。随机ViT加足够拟合的探针已经是非平凡的基线,多个自监督方法在预测任务上仅提供适度改进。最后,预测性能在不同评估期间的变化显著大于不同随机种子。图5显示月份解释了几乎所有观察到的评估性能变化。这使得跨市场体制评估比单期内重复评估重要得多。
缩放与衰减
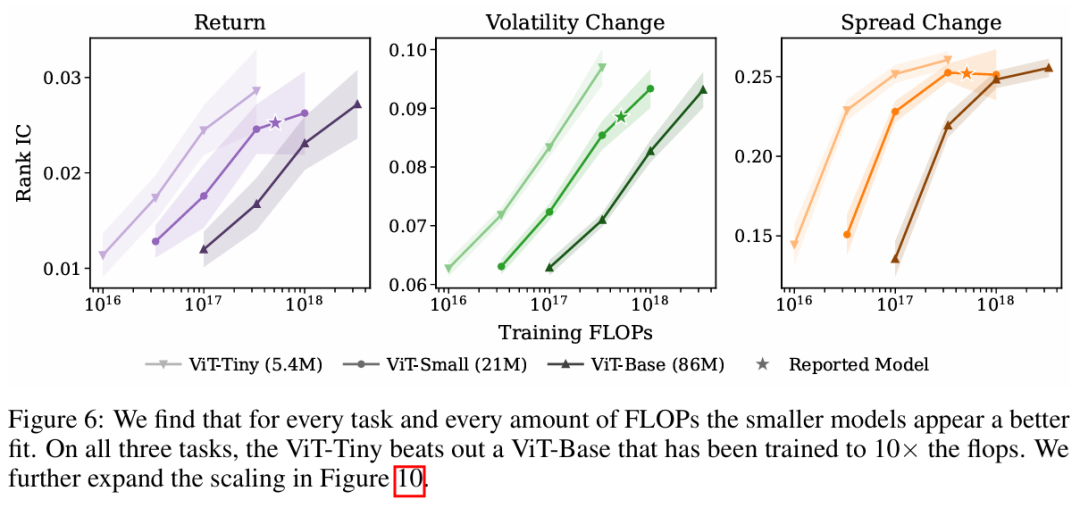
在固定训练计算预算下,较小编码器在预测任务上始终更有效。在无相应有用统计信息增加的情况下增加模型大小因此似乎在降低计算效率。关于时间衰减,因为预测任务的内在难度随市场体制变化,直接评估作为模型年龄函数的性能会混淆表征衰减与评估期可预测性的变化。我们因此将每个模型与在更接近评估日期训练的匹配模型比较。在此相对比较下,收益表征显得相对持久,而波动率和价差表征随着训练期远离评估而退化。
潜在结构
预测本身并不决定表征是否为世界模型提供有用状态空间。SSL的谱视图将目标解释为在观测值之间诱导关系并学习在结果图上平滑的嵌入[9, 7]。在市场环境中,这种关系来源于共享时间段、持久公司特征、行业暴露和共同统计因子,提供了测试表征是否捕获超越下一次收益预测可见的有用市场结构的自然测试。
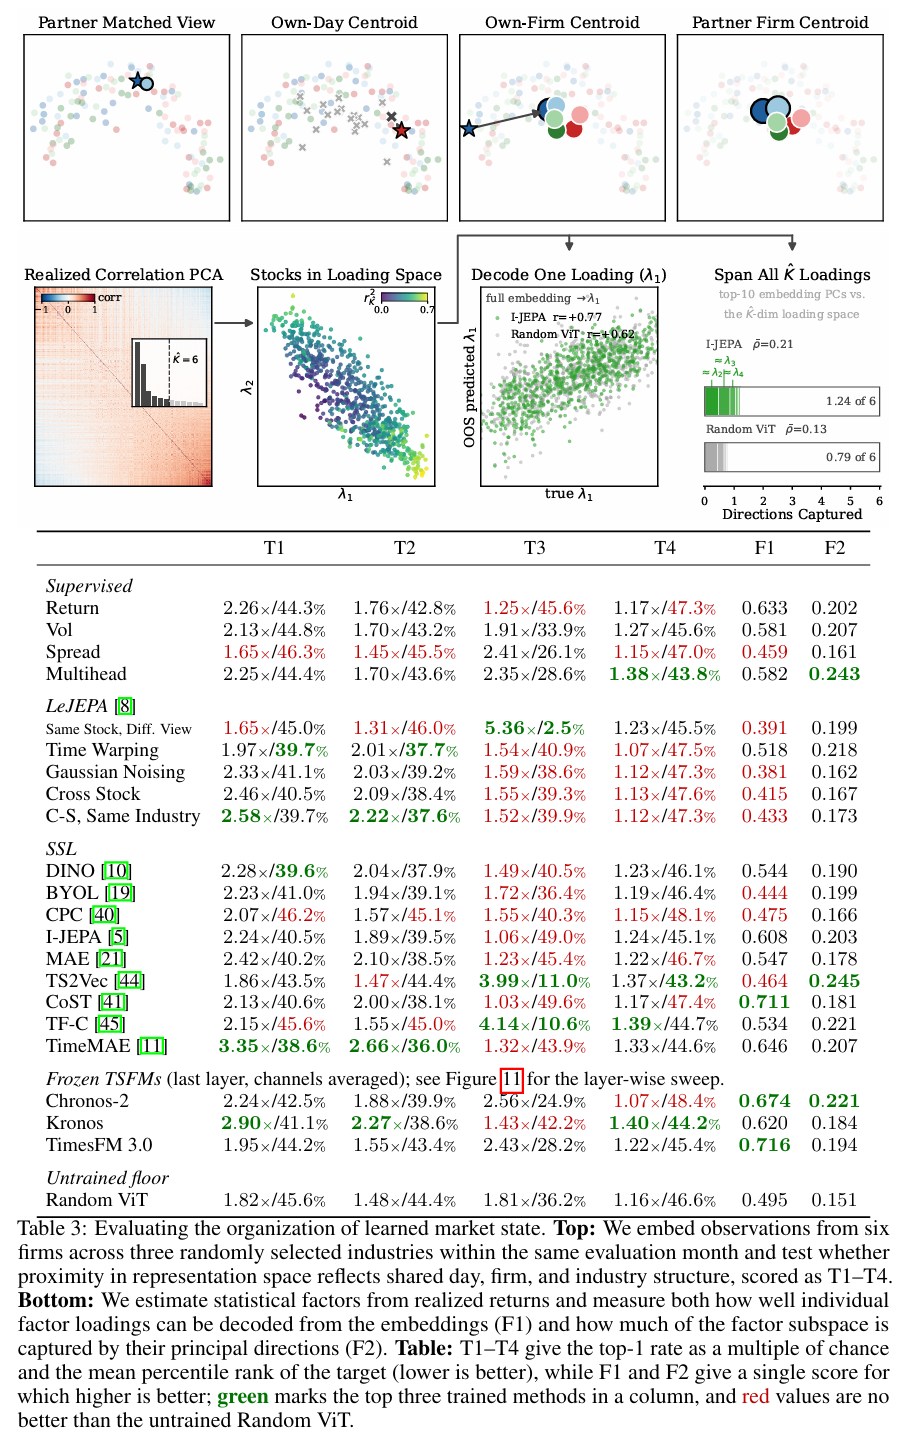
有效秩。 我们首先使用RankMe[17]测量每个表征的有效秩。监督模型倾向于将其变化集中在相对较少的方向,而多个自监督目标产生显著更高维的嵌入。
组织。 我们接下来测试表征空间中的距离是否反映观测值之间具有经济意义的关系。一个表征可能根据交易日组织观测值,捕获跨公司共享的市场条件,或根据公司身份和相关横截面特征组织,捕获关于单个证券的持久信息。我们通过涉及匹配视图、日质心、公司质心和经济相关公司的检索任务评估这些替代方案。
潜在统计因子。 我们的最终潜在空间评估询问嵌入是否恢复解释跨股票联合运动的统计因子。跟随[37],我们从评估月的已实现收益估计因子。对每个公司,我们平均其月内嵌入并测试两个属性:(i)公司对每个收益因子的载荷能否从其嵌入解码,(ii)嵌入的前导主成分是否跨越收益因子子空间。
总结。 预测性能和潜在空间组织捕获的表征属性大体不同:跨方法,其排名仅弱相关(ρ = -0.19)。监督多头模型是唯一在每个潜在空间评估上超过随机ViT的训练模型。
总结
监控和理解金融市场,然后行动以最大化预期结果是现代经济的核心挑战。这种决策需要金融市场的世界模型,然而构建世界模型始于表征学习问题:在学习动态或规划行动前,我们需要知道状态表征保留什么信息以及这些信息对哪些任务有用。为支持金融世界模型的发展,我们引入Market-1T,一个覆盖2008-2025年美国上市股票近万亿观测值的一秒分辨率数据集,开发严格评估协议,并用以系统评估18种跨多个市场体制的编码器训练策略。我们既测量关于未来市场演变的预测信息,也测量学得潜在空间中具有经济意义的结构。
两个结论浮现。第一,预测性能跨市场体制变化显著,使单一近期时期评估不可靠。第二,表征质量是多维的:保留预测信息的方法不一定保留公司、时间、跨资产或统计因子结构。这对世界建模很重要,因为规划行动的模型——例如执行交易——可能需要联合推理预期收益、流动性、波动率、市场整体状况和跨资产关系,以预期市场演变和该行动的后果。有用的金融状态表征因此必须保留超过下一次收益预测所需的信息
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。