MemTrial:当记忆该被信任时,如何教会 AI 区分可靠经验与噪音
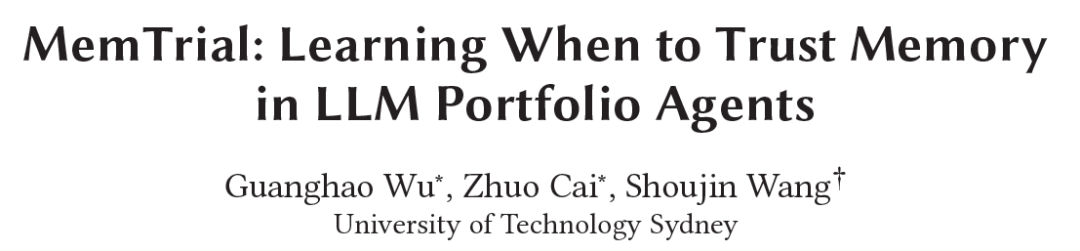
“MemTrial: Learning When to Trust Memory in LLM Portfolio Agents”
大语言模型代理在决策时,常常依赖从过往经验中检索到的"记忆"。然而,并非每条记忆都值得信任:有些经验早已过时,有些只是巧合的噪音,甚至可能误导决策。当 AI 把错误记忆当作可靠经验时,再聪明的模型也会做出糟糕的投资选择。
这篇论文提出的 MemTrial 框架,核心就是解决两个问题:如何度量一条经验对决策的真实贡献?以及,何时应当信任这些经验、何时应当果断忽略?
作者的答案很巧妙。他们把每天的决策设计成一场 $2^{4-1}$ 部分因子实验:从 4 条检索经验中构造 8 种组合,逐一让 LLM 起草方案,从而精确剥离出每条经验的"反事实贡献"。这些有噪声的贡献再被聚合成经验价值,并接受严格的统计检验——只有当价值对未来的预测显著为正时,模型才敢据此行动;否则,它锚定在一个保守参考上,谨慎地小幅调整。
实验结果耐人寻味:在真实市场上,LLM 草稿整体跑输等权组合 1/N,而 MemTrial 的价值几乎从未通过信任检验——这恰恰说明,它最大的贡献不是"更聪明",而是"更懂得克制"。在合成数据存在信号时,MemTrial 则比最好的基线多赚 11%。
当记忆本身不可靠时,学会不信任,或许才是真正的智能。
【 扫描文末二维码加入星球获取论文,源码 】
摘要
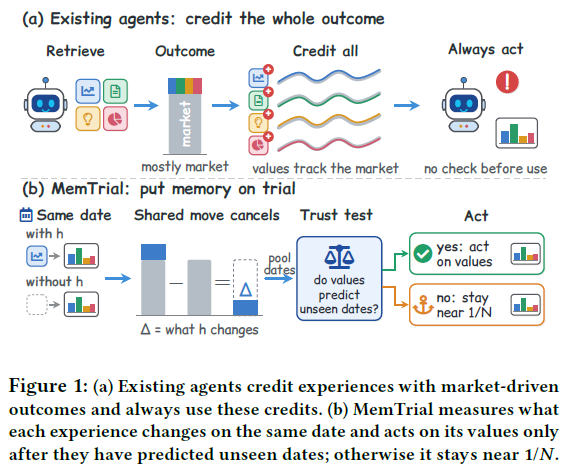
用于投资组合管理的大语言模型(LLM)代理会从经验中学习:它们将使用某条经验所做决策的结果归因于该条记忆。然而在金融市场中,这一结果很大程度上反映的是所有决策在该日期共享的市场走势,因此这种归因追踪的是市场而非经验本身,这些代理往往不如简单地持有等权(1/N)组合。
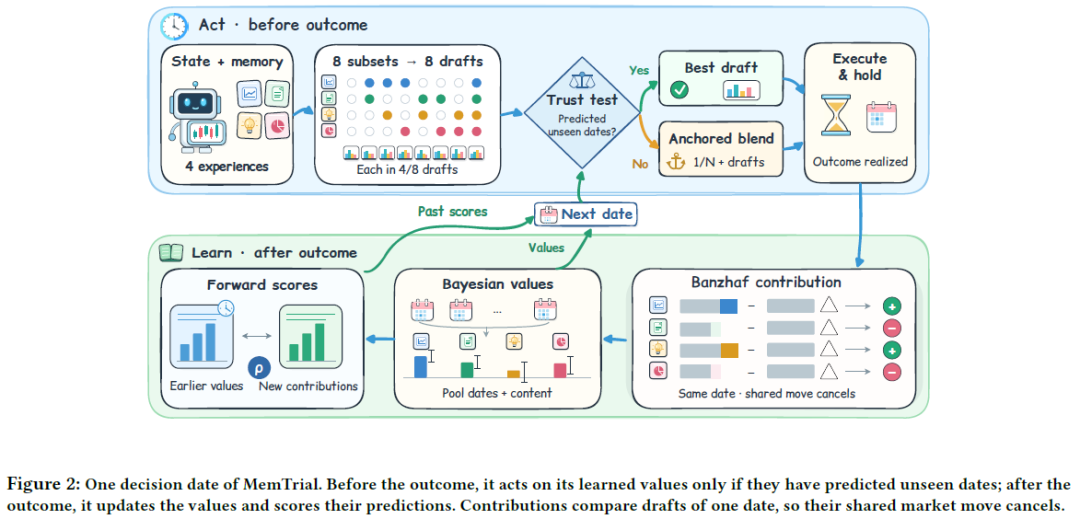
本文提出的核心问题是:代理如何度量一条经验真正改变了什么?答案是"把记忆送上审判席"——包含与不包含某条经验的同一决策草稿面对相同的市场,因此它们共享的结果会在差中抵消。论文提出的代理 MemTrial 用部分因子设计从检索经验中选出子集生成八个草稿,并将每条经验的贡献估计为其 Banzhaf 值——即这些差异的平均。
为此,论文提出 MemTrial(记忆受审),一个通过四步闭环学习何时信任其记忆的经验学习代理:
1) 反事实归因:每天用部分因子设计[6]生成的组合生成八个草稿,把每条经验的贡献估计为其 Banzhaf 值[3, 50];
2) 价值估计:如同小区域估计[15],分层贝叶斯模型把这些有噪声的贡献跨日期、跨相似内容的经验聚合成价值;
3) 信任检验:遵循序列外样本分析[10],代理把预测价值与结果可知后实测的贡献比对,仅当这些样本外前向得分显著为正时才信任其价值;
4) 锚定动作:价值被信任时部署预测价值最高的草稿,否则部署锚定在保守参考(如 1/N)上的混合,并在线学习偏离程度。
论文在三个真实基准 PortBench、InvestorBench、ClassAlloc 及半合成环境 PlantedMem(真实价格与真实 LLM 草稿,每条经验质量已知)上评估。
本文贡献在于:
i) 证明现有经验学习代理的"结果归因"追踪的是市场而非经验变化;
ii) 提出 MemTrial 这一闭环学习框架,学习每条经验的价值及何时可信任;
iii) 面对四个基准上的 14 个基线和八种 LLM,MemTrial 在经验重要时是最好的方法,在其价值不成立时则紧贴 1/N,而现有经验学习代理则明显落后。
简介
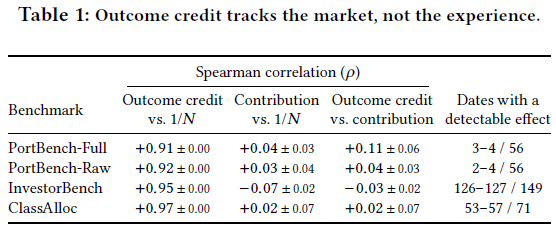
MemTrial 的答案是通过设计实验、价值模型、信任检验与锚定动作的闭环来"审判"记忆。它引入安全部署与估计误差下的组合选择思想:安全策略改进仅在策略以高置信度胜过基线时才部署,序列外样本分析以序列外预测评判模型。组合选择中,DeMiguel 等发现被评估的优化组合无一持续胜过 1/N,这催生了向保守目标收缩的思想。MemTrial 将这些思想引入 LLM 代理的记忆:用前向得分上的信任检验决定是否信任学到的价值,此前则用锚定混合在线学习偏离保守参考的幅度。
MemTrial 的新意不在 Banzhaf 值,而在于如何度量与使用它:在 LLM 决策上通过每天的实验设计测量、聚合进价值模型并被信任。
相关工作
LLM 金融决策代理
近年出现多种用 LLM 代理管理组合的方法,但多数通过结果归因从经验中学习,在金融市场上会追踪市场而非经验本身,常跑输简单的等权(1/N)组合。
LLM 代理中的经验学习与记忆
现有代理对记忆的利用方式各异:FinMem 按相似度、新鲜度与重要性排序记忆;MemRL 从决策回报学习每条记忆的价值并择优;Reflexion 在每次结果后写文字反思;ExpeL 从成败决策中提炼洞察。这些方法都依赖"结果归因"——把使用某经验所做的决策结果归功于该经验,而这一规则在共享市场走势的金融决策中失效。
反事实归因与数据估值
Shapley 值与 Banzhaf 值是分配联合收益的经典方式,数据估值将其用于训练数据:Beta Shapley 按子集大小加权降噪,Data Banzhaf 对所有子集等权,在效用含噪时最稳健。MemTrial 的贡献相当于 $2^{4-1}$ 因子实验中因子的主效应,附录 C.1 证明当与之混淆的三阶交互可忽略时它等于 Banzhaf 值。
估计误差下的安全部署与组合选择
安全策略改进仅在置信度足够时部署新策略;序列外样本分析以序列外预测评判模型。组合选择中,DeMiguel 等发现优化组合无一持续胜过 1/N,催生了向保守目标收缩的思想。MemTrial 将信任检验当作置信度检查、锚定动作当作基线策略,用前向得分检验决定是否信任价值,此前以锚定混合在线学习偏离保守参考的幅度。
MemTrial
问题描述与概述
代理为投资者管理含 N 个资产和现金的组合。在每个决策日期 t = 1, ..., T,它观察市场状态 s_t 并输出组合权重 x_t,这些权重在一个持有期内被持有。投影 P_𝜃 强制投资者的任务约束:风险资产占比上限 M 和防御资产占比下限 m;投资者画像 𝜃 = (M, m, 𝛾) 还含风险厌恶 𝛾。决策由执行组合的投资者效用打分——确定性等价(CEQ)回报:
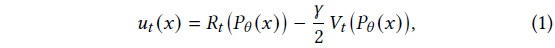
其中 R_t 是持有期扣除比例交易成本后的已实现回报,V_t 是日回报方差乘该期天数(一天时为平方回报)。目标是最优化投资者累计效用  ,通过学习每条经验的价值(从它改变决策之处)及该知识何时可信。在日期 t 结果可知前,MemTrial 用 R_t 的设计子集生成草稿,并按信任检验(§3.4)行动(§3.5);结果可知后,它把效用变化归因到每条经验(§3.2),更新价值(§3.3)并给其预测打分(§3.4)。
反事实归因
设计草稿。为知道一条经验改变了什么,MemTrial 在同一天比较包含与不包含它的决策,如同对照实验:两者面对相同市场路径,共享的结果在差中抵消。比较 k 条经验的所有子集需 2^k 个草稿(k=4 时为 16 个)。部分因子设计用一半草稿度量每条经验的效应:半分数
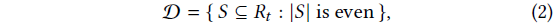
即 2^{4-1} 分辨率 IV 设计。其八个子集含空集与全集,每条经验出现于其中一半、每对出现于两个,因此一条经验的效应不与任何另外两条经验的交互混淆。
贡献作为估计的 Banzhaf 值。设 U_t(S) = u_t(x_t^S) 为用子集 S 生成的草稿在已实现价格下本可获得的效用。第 j 条检索经验的反事实贡献为
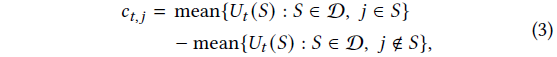
即含该经验的四个草稿平均效用减去不含的四个平均效用。最后在每天内居中贡献:
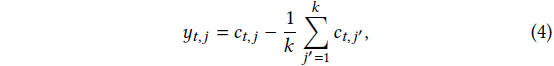
这去除了当天所有检索经验共同的部分,保留区分它们的差异。
价值估计
设经验 h 的中心贡献均值为 m_h,模型为 Fay-Herriot 式分层贝叶斯:
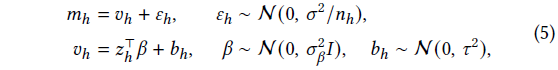
其中 v_h 是经验 h 的价值,z_h ∈ R^d 是内容特征(d = 8 个标准化的检索嵌入主成分),𝛽 把内容映射到价值,b_h 是经验自身偏差。(𝜎_𝛽^2, 𝜏2) 在网格上最大化边际似然
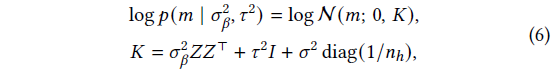
后验均值
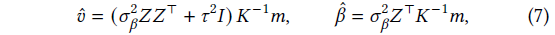
对无测量的新经验,其价值由内容单独预测:E[v'_h'|m]。无内容时(𝜎_𝛽^2 = 0)退化为 James-Stein 型收缩 v~_h:测量次数少的经验被收缩向零(居中后即普通经验的价值)。
信任检验
前向得分。气象预报员的好坏看其对明天天气的预测而非对昨天数据的拟合,序列外样本分析同样评判统计模型。日期 t 前每个学习器仅用结果已知的日期拟合,预测 t 日检索经验的取值 v~_t,j;结果可知后,预测与实测中心贡献比对:
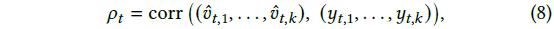
即跨检索经验的 Pearson 相关,天然是样本外的。
信任检验。设 𝜌_1, ..., 𝜌_n 为日期 t 可选学习器的前向得分,均值 𝜌~、标准差 s_𝜌。如同安全策略改进,MemTrial 仅在强证据下信任其价值:当 n ≥ 10 且
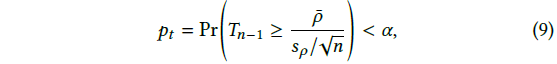
其中 T_n-1 服从 n-1 自由度的 Student t 分布。信任意味着价值在未见日期上对检索经验的排序优于随机;作为每天应用的决策规则,在经验无信号的场景该检验很少通过(§4.5)。被信任时,MemTrial 部署预测总价值最高的设计草稿:
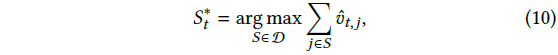
平局时偏向较少经验,且要求总价值为正(即该子集经验预测跑赢平均检索经验);此草稿已为式 (3) 生成,信任不增加额外 LLM 调用。
锚定动作
1/N 组合难以被样本外击败,将它与更进取的策略按数据支持强度加权组合可兼得两者。MemTrial 在线应用此思想:价值不被信任时,部署保守参考 x^ref(真实基准上为投影到任务的 1/N 组合)与平均草稿 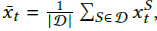 的混合:
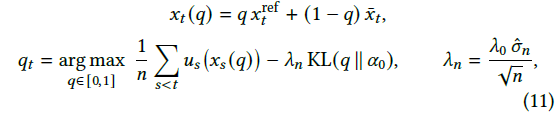
因参考与平均草稿都满足凸的任务约束,每个混合亦然。q 是单个数,式 (11) 在 201 个值的网格上评估目标求解,在已实现价格路径上精确计算每个混合的效用(含交易成本)。结果实现前 q_t = 𝛼_0;随 n 增长 𝜆_n 趋于零,先验权重淡出,q_t 趋近过去日期平均效用最高的混合(类似 follow-the-regularized-leader)。用 𝜎^_n 缩放使 𝜆_0 与效用单位无关,故所有基准都用同一 𝜆_0 = 4。
闭环及其成本
同一组八个草稿服务于每个步骤:产出贡献 (3)、信任动作 (10) 及 (11) 中的平均草稿。MemTrial 每次决策做 |D| = 8 个草稿,并行运行,其 LLM 成本是单草稿代理的八倍。拟合价值模型成本为 O(G . H^3)(G 个网格点、H 条经验),每次决策仅几毫秒。
实验
实验设置
在四个基准进行实验:
PortBench(59 个月度决策,2019年8月至2024年12月,6 类资产含现金,检索 29 条经验);
InvestorBench(63 天热身 + 149 天测试,HON、JNJ、MSFT、UVV 加现金,从热身写的 63 条经验检索 4 条);
ClassAlloc(129 个月度决策,股债商品地产现金五类 89 资产等权指数);
PlantedMem(合成,100 测试种子,每集 132 个月度日期,植入 12 或 48 条经验,其中 $M/4$ 有用、$M/2$ 中性、$M/4$ 误导)。
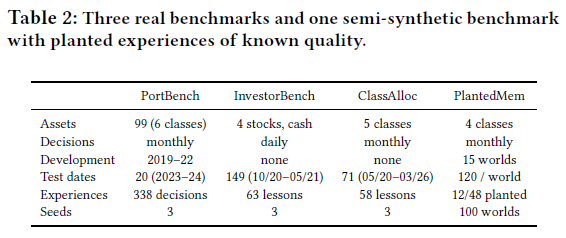
所有 LLM 代理用 gpt-4.1-mini(2025-04-14)温度 0.7,交易成本为移动距离的 15 bp。对比 14 个基线:1/N、最小方差、无记忆、自一致性、相似性检索、FinMem、MemRL、Reflexion、ExpeL、提升归因、反事实选择、草稿平均、Hedge 等。
主要结果
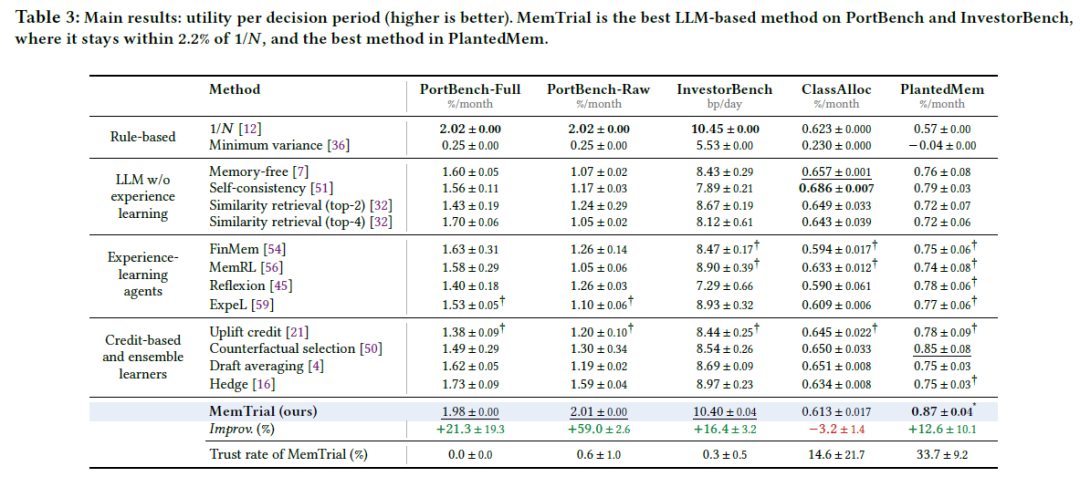
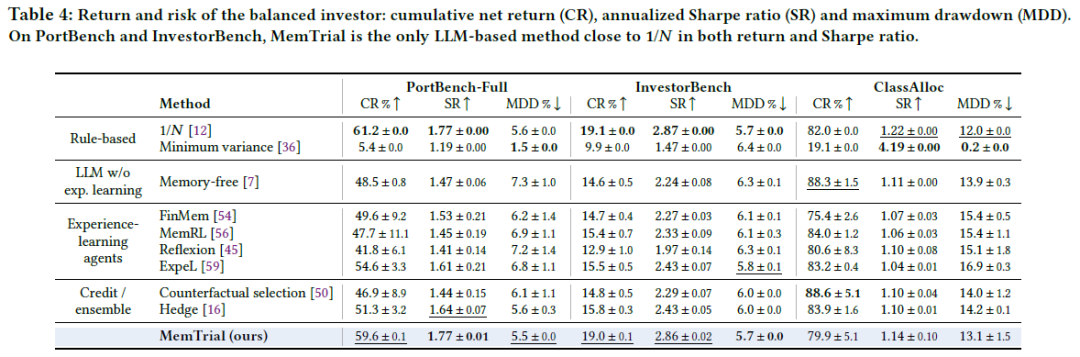
在真实市场上,LLM 草稿整体跑输 1/N。在 PortBench-Full 上无记忆草稿、top-4 检索草稿和八个设计草稿平均每月落后 1/N 0.33–0.42 pp,差距由三部分近似相等构成:毛收益少 0.06–0.16 pp、交易成本多 0.13–0.15 pp、风险惩罚大 0.11–0.14 pp。LLM 每月移动约一半资本离开等权组合(L1 距离 1.0–1.2,对比 1/N 投影后 0.17)。在 InvestorBench 上 LLM 方法毛收益与 1/N 相当(10.7–11.7 对比 11.4 bp/天),但每天大幅调仓支付 1.0–2.5 bp/天交易成本,而 1/N 为 0.1 bp、MemTrial 为 0.2 bp。
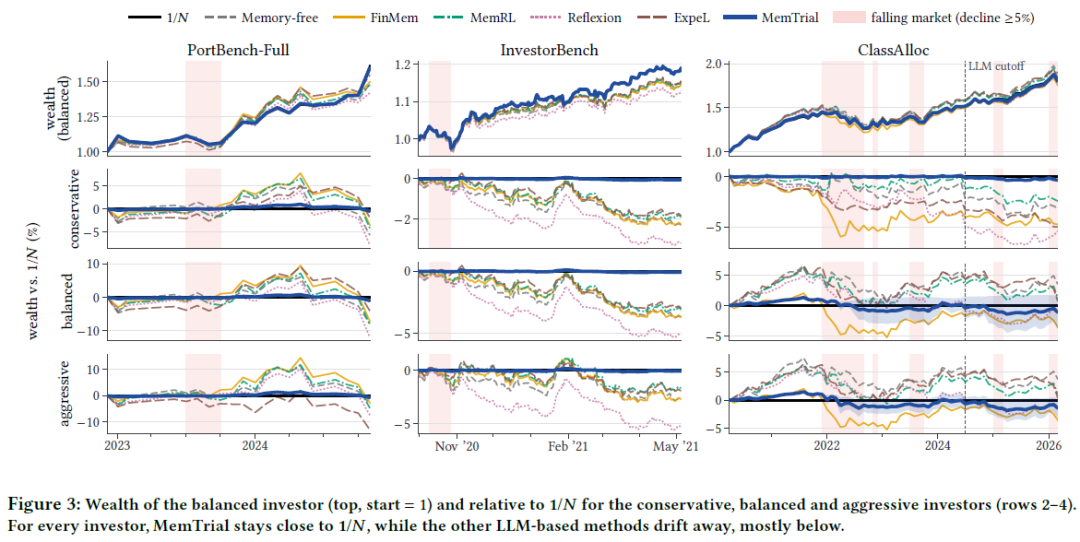
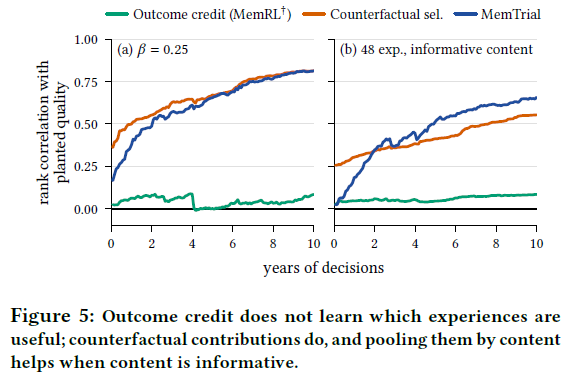
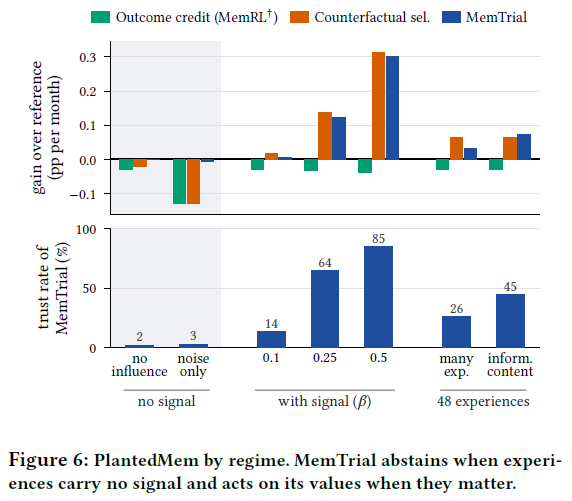
MemTrial 的优势来自三点。第一,经验学习无法弥补草稿与 1/N 的差距,结果归因做不到,MemTrial 的信任检验也发现其价值做不到,故它贴近参考。第二,在 PortBench 和 InvestorBench 上,从过去日期学到的价值不能外推到未见日期,信任检验几乎不通过(至多 0.6% 的决策,表 3);反事实选择无此检验直接行动,落后程度与其他代理相同。第三,锚定保护了 MemTrial:草稿平均部署同一组八个草稿却远落后 1/N,但用相同锚定时每个 LLM 基线都进入 MemTrial 的 1% 以内。在存在信号的 PlantedMem 中,MemTrial 比最好的锚定基线多赚 11%,因其充分行动于已预测未见日期的价值上。
消融分析
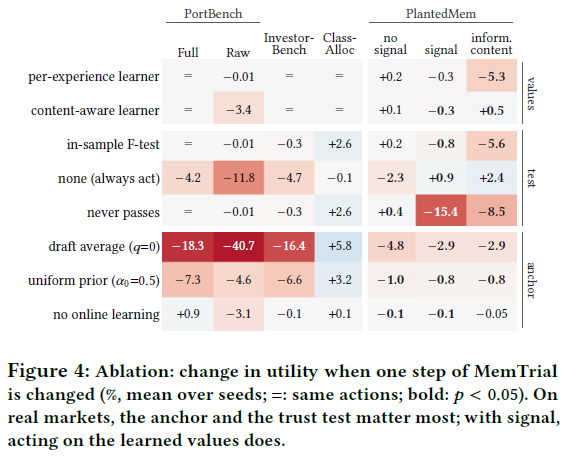
图 4 每次改变 MemTrial 一个步骤(PlantedMem 拆分为无信号核心机制、有信号机制及 48 经验信息性内容机制)。真实市场上锚定与信任检验最重要:用草稿平均替换锚定混合在 PortBench 和 InvestorBench 损失 16–41%;无信任检验直接行动损失 4–12%(因价值无法外推)。信任率方面,无信任检验时 MemTrial 在 24.7%–34.5%(PortBench/InvestorBench)乃至 53.8%–64.9%(ClassAlloc/PlantedMem)决策上行动,而带检验时至多 0.3%。先验权重设置权衡:均匀先验(𝛼_0 = 0.5$)在 PortBench 和 InvestorBench 损失 5–7%,但在草稿跑赢 1/N 的 ClassAlloc 上收益 3.2%;相反极端(始终保留参考,q=1)在无法击败 1/N 时收益、在草稿更好时损失。在线学习混合影响较小:固定为先验(q = 𝛼_0)仅改变效用 −3% 到 +1%。在信任检验最常通过的 ClassAlloc 上,从不行动反而好 2.6%。
对 LLM 的稳健性
除 gpt-4.1-mini 外,论文还测试了 gpt-4.1-nano、gpt-5-mini、Llama-3.3-70B-Instruct、Qwen3-235B、DeepSeek-V3.1、Gemini 2.5 Flash 和 Claude Haiku 4.5 等八种 LLM(附录 D.12、D.13),提示词不变。在 InvestorBench 和 ClassAlloc 上分别由各 LLM 写经验与洞察。结果对 LLM 选择稳健,MemTrial 的经验学习优势不依赖特定模型。
其他分析
案例研究揭示信任检验的行为。在 ClassAlloc 上,贡献有噪声且价值小:L18/04 在两个日期都有助(+0.12 和 +0.28 pp),L17/05 在两个日期都有害(−0.42 和 −0.21 pp),但收缩后种子 1 的所有价值绝对值都低于 0.02 pp,部署草稿由微小差异决定。
信任检验决定 MemTrial 是否承担草稿的市场敞口:四月每条草稿在下跌前超配股票,行动于价值损失 1.66 pp(对比 1/N);九月每条草稿防御,检验勉强未过,锚定动作放弃所选草稿领先的 2.02 pp。
整个 71 个月中行动于价值在 ClassAlloc 未获益:检验通过的 93 次决策中,受信任草稿比其替代的锚定混合少赚 0.05 pp(s.e. 0.07),从不行动变体每月好 0.016 pp。弱参考情形下(附录 D.8),参考 1/N 在核心机制每月 0.71%,锚定动作学向草稿 0.75%,均匀先验更快 0.81%;从不行动仅 0.62%,故弱参考时价值更重要。
总结
MemTrial 通过把记忆送上审判席来学习何时信任记忆:每天用部分因子设计度量每条检索经验的反事实贡献(Banzhaf 值),用分层贝叶斯模型聚合价值,用样本外信任检验判断价值是否预测了未来,并仅在受信任时行动、否则锚定在保守参考。在真实市场上,MemTrial 的价值很少通过信任检验(在那些通过之处,如 ClassAlloc,行动也未胜过锚定),其优势主要来自锚定,而锚定同样保护基线,因此真实市场从记忆的收益仍有待证明。在存在信号的 PlantedMem 中,信任检验正确通过,MemTrial 充分行动于已验证价值,比最好的锚定基线多赚 11%。MemTrial 的"少即是多"——懂得克制、在该不信任时不信任——是其核心洞见。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
