为什么AI认得出"钻石公主号",却认不出那些冷门的历史事件 Оригинал на китайском
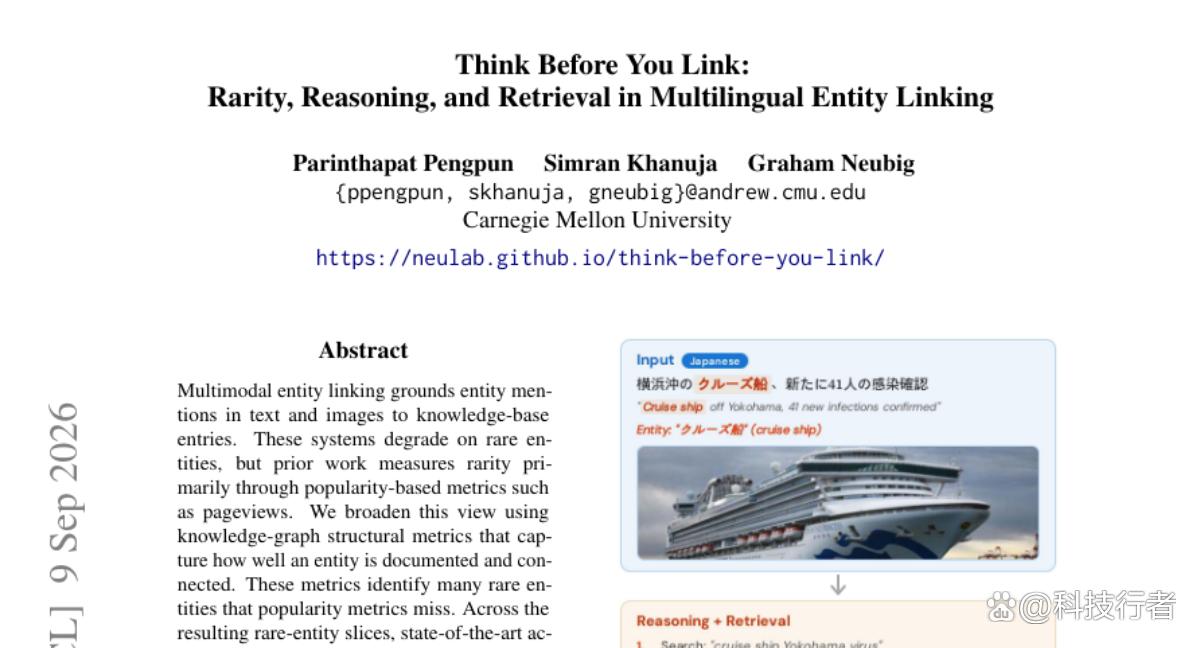
2020年初,一艘叫"钻石公主号"的邮轮因为新冠疫情被困在横滨港外,当时日语新闻只写着"クルーズ船"(意思就是"邮轮"),连船名都没提。
如果你是一个AI系统,光看这几个字,你怎么知道说的是哪艘船?世界上有几千艘邮轮,新闻里写的又只是个泛称。但如果你多看一眼配的照片,船体上用大字写着"Diamond Princess",答案立刻就清楚了。
这个案例其实点出了一个说起来简单、做起来极难的任务:多模态实体链接。
实体链接*:把文本里提到的某个人名、地名或事物,对应到知识库里具体的词条上,比如维基百科的某个页面。多模态,指的是这个过程既要看文字,也要看图片,两者配合才能找到正确答案。
这个任务表面上像个查字典的活,但卡内基梅隆大学的研究团队发现,现在最先进的AI系统在处理"冷门"实体时,表现会大幅跳水,而且他们衡量"冷门"的方法本身可能就有问题。这篇论文想解决的,正是这两件事:什么才算真正的冷门,以及怎么让AI系统在冷门实体上也能表现得像模像样。
冷门,到底是谁说了算
先说一个可能会颠覆你直觉的事实:一个entity(实体)可能每天有几十万人在维基百科上搜索它,浏览量高得吓人,但AI系统照样对它一知半解。
这听起来有点反常。我们通常觉得,越热门的东西,资料应该越全,AI应该越熟悉才对。但研究者发现,浏览量高低和这个实体"被充分记录"其实是两件不同的事。
举个论文里提到的真实例子。2016年印度废止大额纸币这件事,当时闹得沸沸扬扬,英文维基页面浏览量高达3.6万,编辑过980次,内容看起来相当扎实。但如果你去看它在维基数据(Wikidata)里的结构化信息,只有区区11条陈述。这就好比一个人朋友圈天天刷屏、粉丝一大堆,但你去查他的档案资料,发现社保、学历、工作经历全是空的。反过来还有个例子叫"Muttahida Qaumi Movement"(一个巴基斯坦政党),英文维基页面写得很单薄,可它在知识图谱里却有287条入链,信息网络织得很密。
维基数据*:一个结构化的知识库,记录实体之间的关系,比如"某人是某国总理""某事件发生在某年"这类可以被机器直接读取和关联的陈述,和维基百科那种自由文字叙述不一样。
这两个例子说明,一个东西可以"热"但"薄",也可以"冷"但"厚"。过去的研究几乎全部用浏览量、入链数这类"人气指标"来定义什么叫冷门实体,但这套标准完全没抓住这种错位。
研究团队于是换了个角度,不只看"有多少人关心它",还看"这个实体在知识网络里被记录得有多扎实、连接得有多密"。他们从维基百科和维基数据两边一共收集了15种指标,包括浏览量、反向链接数、文章字数、修订次数,也包括维基数据里的入链数、出链数、语言版本数、陈述数量、限定词数量等等。
限定词*:维基数据里给一条陈述附加的补充说明,比如"某人在某个时间段担任某个职位",这个"时间段"就是限定词,用来让陈述更精确。
按照这套新标准重新划分"冷门实体"(论文里取每个指标排名最后5%的实体作为冷门集合)之后,一个很扎眼的结果出现了:用不同指标划出来的冷门实体名单,平均只有37%是重叠的。换句话说,如果你只看浏览量去找冷门实体,你会漏掉将近三分之二在结构上真正稀疏、真正难处理的实体。有些指标对之间的重叠率甚至只有10%。
这就好比你想找班里"跟不上进度"的学生,但你只查了他们的出勤率,完全没管作业完成度和考试成绩。出勤率高的学生里,照样可能藏着一大批作业空白、成绩垂直下滑的人,而你压根看不到。
那么这种被以往标准漏掉的冷门实体,到底会不会真的让AI系统栽跟头?
答案很直接:会,而且栽得不轻。
研究团队测试了当时在MERLIN基准上表现最好的模型,叫Cultural Pangea。
MERLIN*:一个专门用来测试多语言、多模态实体链接能力的基准数据集,覆盖印地语、印尼语、日语、泰米尔语、越南语五种语言,每条数据都配有文本、图片和一个需要被链接的实体提及。
Cultural Pangea*:目前MERLIN基准上表现最好的模型,它专门用文化相关的数据做过微调,理论上应该对多样化、非西方中心的实体有更好的适应能力。
Cultural Pangea在完整测试集上的平均准确率是81.1%,已经相当不错。但研究者把它拿到各个"冷门5%切片"上单独测试,发现准确率暴跌15.4%到39.9%。更值得琢磨的是,这种暴跌不只发生在人气指标划出的冷门集合上(浏览量切片跌了37.7%),在维基数据结构指标划出的冷门集合上跌得同样惨(陈述数量切片跌了37.0%)。因为这两类冷门集合重叠率只有37%,这意味着如果你只用人气指标去做评估,你会完全漏掉一大批模型同样表现糟糕的实体。这就相当于医生只测体温来判断病人有没有生病,结果漏掉了一大批体温正常但其他指标全部异常的病人。
这个发现直接推动了研究团队去思考解决方案:既然问题的根源是这些实体在模型训练数据里"没被好好教过",那有没有办法让模型在推理的当下,临时去查资料补课?
让AI学会边想边查
研究团队提出的方案说起来其实不复杂:让一个具备推理能力的视觉语言模型,一边琢磨、一边去维基百科上主动搜索,反复迭代,直到它有足够信心给出答案。
视觉语言模型*:一种同时能理解图片和文字的AI模型,可以看图说话,也可以结合图文信息做判断。
这套方案的核心逻辑是这样的:冷门实体大概率没有被塞进模型的参数里,那就别指望模型凭"记忆"回答,而是给它一个搜索工具,让它像人一样,遇到不确定的东西就去查。但光会查还不够,因为实体消歧往往需要多步推理,比如先看图片线索,再结合上下文缩小范围,再验证候选答案是否合理。
于是研究团队设计了一个两模块的流水线。第一模块是一个具备"思考"能力的模型(论文用的是Qwen3-VL系列,分别测试了2B、4B、8B三种参数规模,每种规模又分为Thinking和Instruct两个版本),让它反复搜索维基百科,最多可以搜20次,每次搜索后把结果融入自己的推理过程,直到给出一个自认为可信的答案。第二模块则单纯负责从这段冗长的推理文字里,提取出最终那个干净的维基百科标题。
Thinking和Instruct*:同一个模型家族里的两种变体。Thinking版本经过强化学习训练,会先生成一大段推理过程再给答案,类似"思考再回答";Instruct版本则是标准的指令微调模型,倾向于直接给出结果,不做太多中间推理。
检索环节,研究团队试了两种技术路线。一种是BM25,属于传统的关键词匹配方法,查询词和文档词重叠越多,匹配分数越高。这个方法的天然弱点是,当实体提及是用非拉丁字母(比如日语、泰米尔语)写的,而目标是英文维基百科标题时,字面上根本对不上,搜索直接失效。另一种是基于多语言语义嵌入的检索,用一个叫multilingual-e5-large-instruct的嵌入模型把查询和文档都转换成向量,再用FAISS做相似度检索,这样即使字面不同,只要语义相近也能匹配上。
BM25*:一种经典的关键词检索算法,核心思路是统计查询词和文档词的重叠程度来打分,速度快但对跨语言、跨文字系统的匹配能力较弱。
FAISS*:Meta开发的一个高效向量检索库,能在海量向量里快速找出和查询最相似的那些,常用于语义搜索场景。
这里有个特别值得琢磨的细节:研究团队规定,每个例子的第一次搜索必须强制执行,不能让模型自己决定要不要搜。为什么要这么做?因为他们在预实验里发现,2B规模的小模型经常压根不去调用搜索工具,直接凑一个答案敷衍了事。如果没有这条强制规则,一个号称"启用了检索"的实验配置,实际表现可能跟完全没检索一样,数据就失真了。这就像你给员工配了一部专线电话用来核实客户信息,但如果不强制要求他至少打一次,有些员工图省事,压根不打,直接猜测客户信息就往上报,你根本发现不了这部电话到底有没有用。
那么,这套"边搜边想"的方案,到底管不管用?
推理和检索,谁在真正起作用
先看整体数据。研究团队最好的配置是8B参数的Thinking模型配合语义嵌入检索,在MERLIN完整测试集上跑到了87.9%的平均准确率,比Cultural Pangea的81.1%高出6.9个百分点。在印地语和印尼语上,提升幅度达到了10个百分点。
但更有意思的故事发生在冷门实体切片上。同样是这套8B配置,在按限定词数量划分的冷门切片上,准确率优势从整体的6.9%飙升到23.3%;在按陈述数量划分的切片上是22.1%;按维基数据出链数划分的切片上是21.7%。15个冷门切片里,14个的提升幅度都超过了整体数据集上的提升幅度。
这组数字背后藏着一个更深的问题:这个提升到底是"推理"带来的,还是"检索"带来的,还是两者缺一不可?
研究团队做了一套严谨的对照实验来拆解这个问题,结果相当出人意料。
单独看推理能力的作用(也就是比较Thinking版本和Instruct版本,两者都不联网检索,只靠模型自身参数里的知识),在所有冷门切片上,这个差异统计上都不显著,p值全部大于0.5。换句话说,光靠"想得更认真",模型并不会因此更懂那些冷门实体,因为这些实体本来就没被塞进模型参数里,想得再深也想不出没学过的东西。
单独看检索的作用则出现了戏剧性的分裂。对Instruct(非推理)模型来说,加上BM25检索之后,整体准确率反而下降了4.9%,但在结构性冷门切片上,同一套BM25检索却带来了8.1%到12.6%的提升。这个现象背后的原因,研究团队通过分析搜索日志找到了:Instruct模型平均每个例子要发起3.2到5.2次搜索,而且这些搜索之间几乎没有任何思考停顿,前后两次搜索之间生成的文字只有26到30个token,基本等于"搜完立刻搜下一个",完全没有消化上一次搜索结果的过程。这就好比一个人在图书馆查资料,翻开一本书扫一眼封面立刻扔掉去抓下一本,连目录都没看,查了十本书脑子里什么都没留下,反而越查越乱。这种粗放式检索在常见实体上会把正确答案淹没在一堆无关信息里,拖累整体表现,但在冷门实体上,因为模型本来什么都不知道,随便捞到点相关信息都是净赚。
而Thinking模型的搜索行为完全是另一种画风。它们平均每个例子只搜1.0到2.2次,但每次搜索之间会生成1454到1534个token的推理文字,认真分析检索结果、判断要不要继续搜、下一步该搜什么。这种"少而精"的搜索策略,让检索增益在Thinking模型上从来不会出现负面效果:整体数据集上提升3.8%,在语言版本数这个冷门切片上提升竟然达到18.8%,是整体提升幅度的5倍。
这组对比其实揪出了这篇论文最核心的一句话结论:推理本身不解决冷门问题,检索本身能解决一部分但可能伤及无辜,只有两者结合,才能既吃到检索带来的信息增量,又不被检索带来的噪音拖垮。
这也让人想起一个生活里的经验:给一个从来没学过做饭的人一本菜谱,如果他能耐心读、能理解每一步为什么这么做,他能做出一道好菜;如果他只是机械地照着菜谱一步步搬,不理解背后的逻辑,遇到食材不齐全或者火候有偏差的情况就容易翻车。检索就是那本菜谱,推理能力决定了你是照着菜谱理解性地做菜,还是机械地照本宣科。
研究团队还发现了一个规模效应的细节,挺值得单独说一说:一个4B参数的Thinking模型配上语义检索,整体准确率是83.7%,几乎和8B参数的Instruct模型(83.5%)打平,但在冷门实体上,这个小一半参数量的模型反而赢了5到7个百分点。这说明"会不会用检索工具、会不会思考"这件事,有时候比"脑子里塞了多少参数"更重要,给了一个用更少算力实现同等甚至更好效果的思路。当然代价也是有的,这个4B配置消耗的推理token数量是同规模无检索版本的将近2.8倍,相当于用更多的思考时间换回了更小的模型体量,这是一种典型的算力置换。
错误从哪里来
光看准确率数字容易忽略一件事:即便是表现最好的那套系统,依然有841个例子答错了。研究团队没有把这些错误一股脑扔进"失败"这个筐里草草收场,而是花了工夫做了细致的错误分类。
他们发现,超过一半(51.8%)的错误属于"完全答错",模型给出的答案和正确答案毫无关系。第二大类是"名称格式"问题,占21.4%,也就是模型可能已经找到了对的实体,但输出的标题格式和标准答案不完全一致,比如多了个括号说明或者用了缩写。第三类是"消歧歧义",占13.3%,模型在多个候选实体之间选错了那个具体的。
其中最能说明问题的一类错误,叫检索失败:在72%的错误案例中,正确答案压根没有被搜索结果召回过。也就是说,不管模型思考得多认真、多有条理,如果搜索引擎从一开始就没把正确答案递到它面前,再厉害的推理也是巧妇难为无米之炊。
论文里举了一个特别典型的例子。日语里"米"这个字,在新闻语境里经常是"米国"(意思是"美国")的简写,但模型把它当成了一个姓氏,去搜"Mi姓氏",压根没往"美国"这个方向想。同样的问题也出现在"英"字上,它经常是"英国"的简写,模型同样理解错了。这类错误暴露出跨语言检索目前最大的软肋:源语言里那些约定俗成的缩写和转喻,很难被字面检索或者语义检索准确捕捉,因为它需要的不只是语言知识,还需要对这门语言文化习惯的深刻理解。
研究团队还专门比较了拉丁字母语言(印尼语、越南语)和非拉丁字母语言(印地语、泰米尔语、日语)之间的差异,发现在非拉丁字母输入上,检索失败占错误总数的比例高达76.8%,比拉丁字母输入的62.5%明显更高,而语义嵌入检索相对于BM25的优势,在非拉丁字母输入上也更明显(提升6.9%对比拉丁字母输入的6.3%)。这说明语义检索确实部分缓解了跨文字系统带来的匹配困难,但没能完全解决。
这就好比你在国外旅行,当地招牌全是你不认识的文字,即便你随身带着一个翻译软件(相当于语义检索),遇到一些约定俗成的俚语缩写或者文化梗,翻译软件也未必能准确领会,你还是可能问错路。
写在后面
读完这篇论文,最让我意外的其实不是那个87.9%对81.1%的提升数字,而是那个37%的重叠率。
研究团队用15种不同的指标去划分"什么算冷门实体",结果这些指标划出来的冷门实体名单,平均只有三分之一是重合的。这意味着过去几年,几乎所有拿"浏览量低"当作冷门定义标准的研究,可能都只看到了冷门问题的一个侧面,还有另外三分之二的困难案例,压根没被纳入过考量范围。
这让我想到一个更普遍的问题:我们在评估任何系统的时候,往往会不自觉地选取一个最容易测量的指标当作代理变量,然后把这个代理变量的表现等同于真实问题的全貌。浏览量好测,维基数据的结构连通性不好测,所以大家都用浏览量。但好测和准确,从来不是一回事。
还有一个细节让我反复琢磨:GLM-4.6V-Flash这个模型家族在做交叉验证的时候,它的非思考模式压根撑不住这个"边搜边想"的循环,大概15%的例子里会陷入token重复,最后耗尽生成预算什么都没输出。这说明"检索加推理"这套组合拳,不是随便拿个模型接上搜索工具就能跑起来的,它对模型本身处理长链条工具调用的稳定性有相当高的要求,这也是这篇论文没有明说但值得后续研究继续追问的地方。
冷门实体的问题,说到底可能不是一个纯粹的技术问题,而是一个关于"文化能见度"的问题。维基百科本身对西方文化的记录密度就明显高于其他地区,这套系统再怎么优化检索和推理,也没法凭空补全知识库里原本就缺失的内容。技术能做的,是尽量不要在已有的信息里迷路,但如果信息本来就不存在,再聪明的模型也无从谈起。
那些被记录得稀薄的文化和历史,会不会永远比那些被反复书写的主流叙事,更难被AI真正理解?
Q&A
Q1:MERLIN基准是什么?
A:MERLIN是一个多语言多模态实体链接测试基准,覆盖印地语、印尼语、日语、泰米尔语、越南语五种语言,每条数据包含文本、图片和一个需要被链接到英文维基百科词条的实体提及,用来检验AI系统在不同语言和视觉线索下识别实体的能力。
Q2:为什么用浏览量判断实体是否冷门不够准确?
A:因为浏览量只反映大众关注度,不代表这个实体在知识图谱里是否被充分记录。论文发现不同冷门指标划出的实体名单平均只有37%重叠,很多浏览量高但结构信息稀疏的实体会被浏览量指标完全漏掉,导致模型在这些实体上的失败被忽视。
Q3:推理能力和检索功能哪个对识别冷门实体更重要?
A:两者缺一不可。单纯提升推理能力对冷门实体准确率没有显著帮助,因为模型本身就没学过这些知识;单纯加检索对非推理模型有时反而拖累整体表现;只有推理模型配合检索,才能既获取新信息又有效利用,在冷门切片上带来最多23.3%的提升。