会看场合的AI手势生成,让虚拟人懂得坐姿站姿和身边的桌椅 Оригинал на китайском
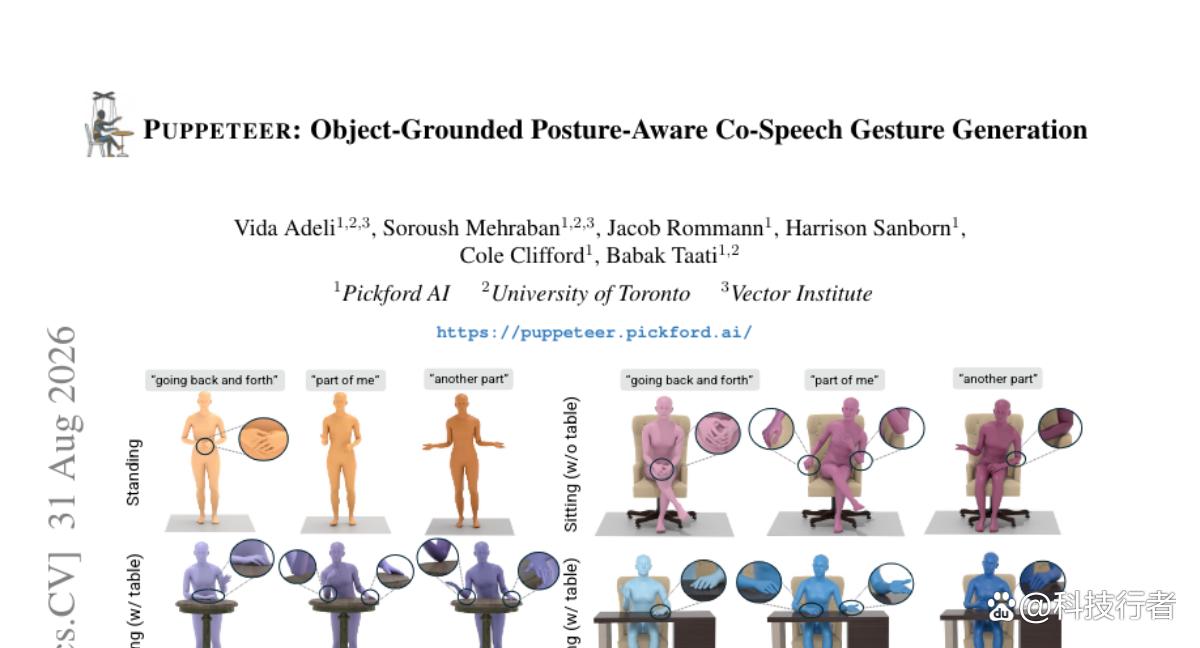
你有没有观察过,人在不同场合说话时,手是怎么动的?
站着演讲的时候,手臂可以大幅度挥舞,怎么夸张都不违和。可要是坐在沙发上聊天呢,手往往收着,偶尔搭在扶手上。要是面前还有张桌子,那手基本就不会飞太高,多半是撑在桌面附近比划。这些差异,我们每个人从小到大都在无意识地做,从没觉得这有什么难的。
但如果让电脑来学这件事,麻烦就大了。
**过去几年做"AI生成配音手势"的研究,几乎都默认了一个前提:说话的人是站着的,身边什么都没有。**
这不是研究者偷懒,而是数据集本身就是这么长的。像业内常用的BEAT2数据集,25个人全部站姿录制,念着写好的台词,背景干干净净。你在这样的数据上训练模型,它当然学不会"坐着该怎么比划""桌子挡住了手该往哪放"这些事。结果就是,一旦把生成的虚拟人放进真实场景,比如客服坐在柜台后面,或者两个人隔着会议桌聊天,手势立刻穿帮:手插进桌子里,腿插进椅子里,整个人看起来像个没有物理常识的幽灵。
多伦多大学和Pickford AI的一支团队决定啃这块硬骨头,他们的成果叫PUPPETEER,一个既懂姿态又懂空间的配音手势生成系统。这篇论文里藏着不少值得细讲的设计思路,我们一个一个拆开看。
先搞清楚:这件事到底难在哪
配音手势生成,说白了就是给一段语音和文本,让AI生成一段配套的肢体动作,让虚拟人说话时看起来像真人一样自然。
这事儿本身已经不简单了。手势要跟语音的节奏对上,重音的地方要有相应的手部强调,语义上"这个"、"那个"、"另一部分"这类词还得配合指示性动作。之前的方法比如EMAGE、GestureLSM、DiffSHEG,在这个层面已经做得不错了。
**但它们全都是"场景无关"的:模型脑子里只有语音和文本,完全不知道虚拟人此刻是坐是站,身边有没有桌子椅子。**
这就好比你请了一个很会说话的主持人,口才极佳,抑扬顿挫拿捏得死死的,可你把他放到不同的场地,他每次的肢体动作都一模一样,站在空地上这么比划,坐在沙发里也这么比划,坐在窄小的会议桌后面还是这么比划。观众一眼就能看出违和感,因为真人绝不会这样。
有一篇更早的工作InteracTalker试图往这个方向努力,加入了物体交互能力。但它的做法是"分开训练再拼接":先在标准站姿数据集上训练手势模型,再单独学一个物体交互模块,最后把两者拼到一起。问题是,姿态和环境从生理直觉上讲是同时起作用的,你不能假设它们可以事后拼装。这就像你先分别学会了"用筷子"和"吃火锅",但没人教过你"用筷子涮火锅时手要往哪伸才不会烫到",这个组合技能得专门练。
PUPPETEER团队的思路是:把姿态感知(posture-awareness)和物体感知(object-awareness)都作为第一等公民,直接融入模型架构和训练数据里,而不是事后打补丁。
**姿态感知**:这里指的是模型要理解虚拟人当前是坐着还是站着,具体是什么坐姿站姿,并据此调整手势的幅度和形态,而不是把所有情况都当成同一种默认状态处理。
**物体感知**:指的是周围的桌椅等家具会限制手势的活动空间、影响手的自然摆放位置,模型需要感知这些几何约束,但这不涉及去抓取或搬动物体,只是被动地"绕开"和"贴合"环境。
为了让模型真正学会这两件事,团队做了三层功夫:换用更丰富的数据集来教会模型认识各种姿态,设计新的模型架构让手势生成对时间和语义都可控,以及自己动手造了一个全新的、包含真实桌椅场景的数据集。我们从架构讲起。
核心架构:把手势拆成"因果的乐高积木"
这是整篇论文里最有技术含量、也最值得花时间理解的部分。
先说个背景知识。生成一段连续几十秒甚至更长的手势动作,直接在原始的、高维度的动作空间里做扩散模型(一种通过逐步去噪生成内容的AI方法,图像生成里的Stable Diffusion用的就是这套原理)计算量非常大。所以之前有些方法先把动作压缩成一串离散的"代码本编号"(类似把动作切成固定的几百种标准姿势,每个片段用编号代替),这叫VQ-VAE(矢量量化变分自编码器)方案。
**但离散化会引入量化误差**:一个连续流畅的动作被硬塞进有限的几百个"标准姿势编号"里,细节难免丢失,动作看起来会有轻微的卡顿感。
另一条路是用连续的隐空间(一种压缩后的、比原始数据更紧凑但依然连续可微的数学表示空间)做扩散,这样细节保留得更好,但传统方法用的是双向隐空间,意思是压缩每一帧的时候会同时参考过去和未来的信息。
这就带来一个麻烦:**双向意味着"未来"的信息也混进了"现在"这一刻的表示里,导致你没法精确控制某个时间点该对应哪个词、哪段语音。**
想象你在写一篇同声传译的稿子,如果允许你先看完整篇原文再逐句翻译,翻译质量当然好,但你没法做到实时同步,因为你已经知道了后面要说什么,这会打乱当下这一刻该说什么的判断。手势生成也是同理,如果隐空间里"现在"和"未来"信息纠缠在一起,你就很难精确地让某个手势卡在某个词的发音点上。
PUPPETEER的解法是**因果隐空间**。
这里出现了几个需要解释的术语,放在一起讲:
**CausalVAE**:一种因果变分自编码器,"因果"的意思是,压缩某一时刻动作信息时,只允许参考这一时刻及之前的动作,绝不偷看未来。
**手势基元(gesture primitive)**:把一段长手势切成固定长度的小段(论文里是48帧一段),每一段作为编码的基本单位。
**隐空间token**:每个手势基元经过编码器压缩后,会变成一串排列有序、维度很小的向量,这些向量就叫token,可以理解成"压缩后的动作摘要"。
具体怎么做因果限制的?编码器用的是1D因果卷积(一种只能看到"左边"数据、看不到"右边"数据的卷积计算方式),配合分层残差结构。论文里给出了一个具体数字:编码器的感受野是176帧,但由于每个基元本身只有48帧,实际上模型在基元内部的有效感受野被裁剪成了"从开头到当前这一时刻"。
也就是说,第0个token只看得到第0到3帧,第1个token能看到第0到7帧,最后一个token能看到全部48帧,但绝不会有任何一个token偷看到后面还没发生的帧。
这个设计换来了什么好处?论文的消融实验给出了直接对比。用同样的自回归生成流程,普通VAE的FGD(一种衡量生成动作与真实动作分布相似度的指标,越低越好)是4.221,而CausalVAE只有3.437;BC(衡量动作节奏和语音节奏同步程度的指标,越高越好)从7.570提升到7.693;更关键的是ΔBC(生成动作节奏和真人说话节奏之间差距的指标,越低越好)从0.596骤降到0.201,几乎降了三分之二。多样性指标Div也从10.849涨到14.131。
**为什么因果结构反而带来了更好的语音同步?** 论文的解释是,因果隐空间让训练过程中可以对文本和音频条件做遮蔽(masking)操作,这种做法逼着模型必须在没有"偷看未来"这条捷径的情况下,学会更强的语音和动作对应关系。这就像一个学生如果知道考试时可以翻书,他平时就不会真正把知识记牢;但如果规定考试绝对闭卷,他反而被迫把每个知识点都学扎实了。
在这个因果隐空间的基础上,第二阶段是自回归扩散生成。模型一段一段地生成手势基元,每一段都会参考前面已经生成的历史动作、当前语音片段、以及一个贯穿全程的"初始姿态参考"(也就是这个人一开始是坐是站,具体姿势是什么)。
这里有一个值得单独说说的设计:**强度加权损失函数**。
普通的训练方式对每一帧动作一视同仁地计算误差,这带来一个问题:手势里大部分时间其实是低强度的、接近静止的过渡动作,只有少数时刻才是真正有表现力的"高能量"手势,比如一次用力的挥手或者拍手强调。如果所有帧权重相同,模型很容易学得"偷懒",倾向于生成保守、幅度小的动作,因为这样平均误差更低,但看起来就会显得死气沉沉。
论文的做法是给每一帧一个权重,这个权重和该帧的动作强度成正比,公式是1加上强度平方乘以一个系数λ_I。实验里λ_I取3的时候效果最好,在保持对静止帧监督的同时,把更多的学习压力放在了动感强的片段上。这就像老师批改作文,不会对每一句话平均用力,而是重点纠正那些最容易露怯、最需要打磨的段落,普通的过渡句反而可以宽松一些。
姿态怎么被"记住":从粗糙标签到关节级别的编码
前面提到,PUPPETEER需要虚拟人在整个生成过程中始终记得自己是坐着还是站着,甚至是哪种具体的坐姿。但这事儿并不像想象中那么简单。
如果只靠一小段历史动作窗口来判断当前姿态,长时间自回归生成之后,姿态信息很容易慢慢"漂移"丢失。论文里专门做了一个对比实验来说明这一点:不加任何姿态条件的时候,模型生成的动作会逐渐从坐姿"走"回到默认的站姿,因为训练数据里站姿样本更多,模型有一种回归"平均值"的倾向。
**这就好比你让一个演员连续表演十分钟"坐着开会",如果没有人时不时提醒他"你现在是坐着的",他很容易在不知不觉中就站起来活动开了,因为站着本来就是他更习惯、更"默认"的状态。**
为了解决这个问题,团队引入了一个显式的初始姿态参考,取自动作序列第一帧的下半身关节信息(SMPL-X人体模型的第0到11号关节),把每个关节的旋转和位置编码成向量,再加上一个学习出来的"坐/站"粗粒度标签,一起送进模型。这个参考在整段生成过程中始终固定不变,通过门控交叉注意力机制持续影响后续每一个手势基元的生成。
这里出现了两个术语:
**SMPL-X**:一种业界通用的人体三维网格模型,可以用少量参数完整描述一个人的全身姿态、手部姿态和面部表情。
**门控交叉注意力(gated cross-attention)**:一种注意力机制的变体,模型里加了一个可学习的开关参数,初始值为零,训练过程中逐渐学会该在多大程度上让姿态信息影响手势生成,而不是一开始就强行灌输。
实验数据显示,光是加一个粗糙的"坐/站"二值标签调制,就能把Embody3D数据集上的FGD从3.433降到2.786,下半身位置误差LL1从5.553降到4.297。而换成完整的关节级姿态参考交叉注意力之后,FGD进一步降到1.676,LL1降到2.446。这说明模型不是简单记住"坐着"这个标签就够了,具体是哪种坐姿、身体各关节的空间构型,都会实实在在地影响该生成什么样的手势。
让手势"听懂"语音的节奏和语义
除了姿态,PUPPETEER还专门设计了两套注意力遮蔽机制,用来提升手势和语音之间的同步精度。
**音频窗口注意力(Audio Window Attention)**:限制每个隐空间token只能关注它对应时刻附近的一小段音频,而不是整段音频统统看一遍。
**文本片段注意力(Text Span Attention)**:限制落在某个词语时间范围内的隐空间token,只重点关注这个对应的词,从而强化语义层面的对齐。
为什么要这样限制?如果让模型自由地看全部音频和全部文本,理论上信息量更大,但实际上反而会让对齐变得模糊。这就像开会做同声传译,如果翻译员被要求同时兼顾整场会议的所有发言内容,反而容易在具体某句话上翻得不够精准;但如果他被训练成"每句话只专注当下这几秒钟的语境",反而能翻得又快又准。
消融实验的数字很直观:完全不做任何遮蔽的"Full"设置,FGD是3.917,ΔBC是0.431。加上文本片段遮蔽后,ΔBC降到0.273。单独用音频窗口遮蔽(窗口系数ξ=1),FGD降到3.385。两者叠加使用,FGD是3.437,ΔBC进一步降到0.201,多样性Div也涨到全表最高的14.131。这说明音频节奏对齐和文本语义对齐这两件事,各自解决的问题不完全重叠,叠加起来才是最优解。
物体感知:怎么教AI"看见"桌子和椅子
现在到了这篇论文最独特的部分:让虚拟人真正理解身边有什么物体,并据此调整手势。
首先是怎么表示"人和物体的空间关系"这件事。团队用了一种叫BPS(Basis Point Set,基点集)的方法。
**BPS**:预先在空间里固定撒下一堆参考点,然后计算场景中的物体表面(或人体表面)到这些参考点的最近距离,用这一串距离数值来间接描述几何形状和位置关系,而不需要直接建模复杂的三维网格拓扑结构。
论文对标准BPS做了一处改造,原始方法用一个球体作为参考点的分布区域,PUPPETEER改成了一个椭球体,前方和左右方向的半径(0.48米和0.6米)明显大于垂直方向(0.4米),因为大多数人和物体的碰撞发生在手往前伸或往两侧摆的时候,而不是垂直方向。椭球中心还往前偏移了0.5米、往上偏移了0.1米,更贴合上半身活动的实际范围。
这个物体感知模块是怎么接入模型的?团队采用了一种叫**门控物体融合(Gated Object Fusion)**的模块,插在自注意力层和语音交叉注意力层之间。关键设计是:整个第二阶段(姿态+语音)的模型参数全部冻结,只训练这个新加的物体融合分支。
为什么要冻结主干?如果直接在原有模型上继续训练物体交互能力,很容易发生"灾难性遗忘",就是说模型在学新东西的过程中,把之前辛苦学会的语音-手势对齐能力给冲淡甚至忘掉了。这就像你已经练熟了一套完整的太极拳套路,现在教练要求你在保留原套路每一个动作精髓的前提下,加入几个针对特定场地的微调,这时候最稳妥的做法就是把原套路的肌肉记忆锁死,只单独练那几个新的调整动作,而不是把整套拳重新打乱了从头学。
冻结之后新加的模块用门控残差连接接入,两个可学习的缩放系数α_attn和α_dense初始值都是0,意味着训练刚开始的时候,这个模块几乎不产生任何影响,模型输出和原来的Stage 2一模一样,然后随着训练推进逐渐引入物体信息。此外训练数据里还按4:1的比例混入了原本的BEAT2和Embody3D样本作为"复习",防止模型在学习新技能时把旧本领忘光。
碰撞问题怎么控制?团队引入了一个专门的碰撞损失函数Lcollision,通过构造一个32×32×32的有符号距离场(signed distance field,简称SDF,网格中每个点存储该点到物体表面的最短距离,物体外部为正、内部为负)来判断人体上半身顶点是否穿进了物体内部,如果穿进去了就产生惩罚,惩罚力度和穿透深度的平方成正比。
消融实验数据很有说服力:完全不加物体模块时,平均穿透深度MeanPen是6.476(单位×10??),下半身位置误差LL1是1.019;加了物体模块但不加碰撞损失,MeanPen反而涨到7.302,因为模型虽然学会了利用周围物体信息,但没有约束防止穿模,LL1倒是降到了0.760;最终加上碰撞损失之后,MeanPen大幅降到4.450,同时LL1保持在0.780左右的低水平,多样性Div为11.393。
论文还专门做了一个对比,拿一个不支持场景感知的方法LOM,硬把它生成的动作放进相同的结构化场景里作为参照。结果显示,LOM的平均穿透深度是PUPPETEER的2.8倍,最大穿透深度是2倍,下半身误差LL1更是高达8.4倍。这个巨大的差距说明,场景无关的手势生成,即便动作本身看起来很自然,一旦放进真实空间里,破绽立刻暴露无遗。
值得一提的是,团队还在完全没见过的家具资产上做了零样本测试,模型依然保持了3.280(单位×10??)的低穿透误差和0.86的LL1,说明它学到的不是死记硬背某几件具体家具的形状,而是一种可以泛化到任意新桌椅的空间推理能力。
SCENEGES:从零造一个"带桌椅的人在说话"数据集
前面提到的所有物体感知能力,都需要有对应的训练数据来支撑,但现实中根本不存在这样的数据集:既要有精确的三维人体动作,又要有精确配套的家具三维模型,还得保证人和家具的空间关系是物理正确、没有穿模的。
团队索性自己动手造了一个,取名**SCENEGES**。
制作流程分成五步,挺有意思的。第一步从HSSD数据集(一个专门收录室内场景三维物体的数据库)里精心挑选了106把椅子和47张桌子,覆盖各种不同的造型和结构。第二步搭建简单的场景布局,比如"椅子+桌子"、"只有桌子/台面"、"只有椅子"这几种组合,并渲染出正面视角的起始画面。
第三步是用Gemini这个大语言模型生成对话内容。团队先让Gemini构思一个高层的对话场景(比如办公室里的正式讨论、朋友间的闲聊等),指定好角色、姿态类型(坐无桌、坐有桌、站立、站立有桌)和场景氛围,然后再让Gemini生成具体的多轮对话台词,并且明确标注每句话应该配合什么样的手势,比如"手放在桌上"、"靠着扶手"、"避开障碍物"。
第四步是视频合成,用谷歌的Veo 3模型,把渲染好的起始画面作为参考图像,结合台词和手势提示,生成完整的8秒视频片段,整个过程中物体几何形状保持不变。
第五步是三维动作提取和精修,用SAM 3D Body模型从合成视频里提取每一帧的三维人体姿态,然后由专业动画师手工逐帧修正,消除生成视频里可能存在的空间不一致问题,修正接触点、去除人体和家具之间的穿模,最终得到物理合理、场景一致的三维配音手势数据。
最终SCENEGES包含26种交互场景,覆盖153个物体资产,总时长28分钟。虽然听起来数量不算庞大,但团队还专门做了验证,确认这批合成数据的质量足够可信。
**用户感知研究**方面,23名参与者观看了65段随机抽取自SCENEGES和真实Embody3D数据集的片段,判断哪些是真人拍摄、哪些是合成的。结果平衡准确率只有51.41%,几乎等于瞎猜。更有意思的是,SCENEGES的自然度评分(4.28分,满分5分)甚至略微超过了真实数据的4.09分。
这个数字乍一看有点反直觉:合成数据凭什么比真实数据看起来还自然?合理的解释是,真实录制数据里难免混入一些偶然的、不那么典型的小动作或姿态瑕疵,而经过精心设计脚本和人工精修的合成数据,反而在"典型性"和"流畅度"上更胜一筹。这提醒我们一个道理:数据的真实来源和数据的感知质量,其实是两件可以分开评判的事。
团队还做了运动学层面的量化验证,对比了SCENEGES和Embody3D在上肢手势各项统计指标上的分布,发现两者的中心趋势和离散程度都相当接近,进一步印证了这批合成数据在动力学层面也站得住脚。
实验结果:数字说话
在最核心的BEAT2(Speaker2)测试集对比中,PUPPETEER相较于此前的多个强基线方法都取得了全面领先。
| 方法 | FGD↓ | BC↑ | ΔBC↓ | Div↑ |
|---|---|---|---|---|
| DisCo | 7.586 | 7.652 | 0.224 | N/A |
| CaMN | 6.273 | 7.458 | 0.145 | N/A |
| EMAGE | 5.117 | 5.910 | 1.522 | N/A |
| SynTalker | 4.069 | 7.407 | 0.481 | 10.676 |
| LOM | 4.538 | 6.114 | 1.318 | 9.112 |
| MIBURI | 4.369 | 7.685 | 0.369 | 9.645 |
| GestureLSM | 3.692 | 7.547 | 0.166 | 9.490 |
| **PUPPETEER** | **3.436** | **7.693** | 0.201 | **14.131** |
值得注意的是,EMAGE原版用argmax硬性选取最可能的代码本编号,结果生成的动作是完全确定性的,谈不上任何多样性。作者对比了一个改进版EMAGE*(用softmax概率分布采样代替argmax),多样性确实提升了,但代价是FGD明显变差。也就是说,多样性和真实感在很多方法里是相互拉扯的两难,而PUPPETEER实现了两者同时最优,这正是因果隐空间架构带来的红利。
跨数据集泛化能力方面,只在BEAT2单一说话人上训练的模型,迁移到Embody3D上FGD高达33.649,说明训练数据的多样性直接决定了泛化上限。混入Embody3D共同训练之后,这个数字骤降到2.458左右,再叠加姿态交叉注意力机制,最终降到1.676。
写在后面
读这篇论文的过程中,最让我停下来想了很久的地方,是那个"合成数据自然度评分反而超过真实数据"的结果。
我们平常总有一种朴素的直觉,觉得真实录制的东西天然就比人工合成的更可信、更自然。但SCENEGES这个案例说明,当合成流程足够精细,从场景设计、对话脚本到手势提示都经过反复打磨,再加上人工精修这道保险,合成数据完全可能在某些维度上"表现"得比真实数据还要标准。这让我想到摄影里的道理,一张经过精心布光和构图的照片,有时候看起来比随手抓拍的真实瞬间更"真实",因为它剔除了噪声,只保留了最典型的信息。这对以后做数据驱动研究的人是个提醒:真实性和感知质量,值得分开衡量。
另一个值得琢磨的地方,是论文里反复出现的"冻结主干、只训练新增模块"这个策略。这不只是一个工程技巧,它背后其实体现了一种对"能力优先级"的判断:语音-手势的对齐是根基,物体感知是锦上添花的能力,根基不能动摇,新能力必须小心翼翼地叠加上去。这种思路其实在很多需要持续学习新技能、又不想丢失旧本领的场景里都适用,不只是动作生成。
论文里也坦承了一个还没解决的问题:物体感知模型偶尔还是会出现轻微的穿模,团队直言"绝对零碰撞的物理合理性在整个人体-场景交互领域依然是个开放难题"。这份坦诚挺难得的,没有回避问题,也没有夸大自己解决了一切。
如果哪天你和一个虚拟数字人视频通话,它坐在你对面的沙发上,手自然地搭在扶手边说话,而不是悬空乱挥,你大概可以想到,这背后是一套专门为"坐下来聊天"这件小事,付出了大量工程努力的系统。
Q&A
Q1:PUPPETEER是什么?
A:PUPPETEER是由Pickford AI和多伦多大学团队提出的一种配音手势生成模型,它能根据语音和文本生成手势,同时还能感知虚拟人当前是坐是站,以及身边有没有桌椅等物体,从而生成不穿模、更贴合场景的自然手势。
Q2:PUPPETEER和之前的手势生成方法有什么区别?
A:之前的方法大多只考虑语音和文本,不管虚拟人的姿态和周围环境,容易出现手插进桌子、腿穿过椅子的穿模问题。PUPPETEER通过因果隐空间扩散架构和门控物体融合模块,专门解决了姿态感知和物体感知这两个问题。
Q3:SCENEGES数据集是怎么做出来的?
A:SCENEGES是团队自己造的合成数据集,先挑选真实的桌椅三维模型搭建场景,再用Gemini生成对话脚本和手势提示,用Veo 3合成视频,最后用SAM 3D Body提取三维动作并由动画师人工修正,最终得到26种场景、153个物体资产、共28分钟的物体绑定手势数据。